HA trên Cluster
TÍNH NĂNG HIGH AVAILABILITY (HA) TRÊN PROXMOX VE
1. Giới thiệu
1.1. Khái niệm
High Availability (HA) là tính năng tự động giám sát và cứu hộ máy ảo trong cụm Cluster. Khi một máy chủ vật lý (Node) gặp sự cố đột ngột (mất điện, hỏng phần cứng, sập mạng), hệ thống Proxmox HA sẽ tự động phát hiện và chuyển các máy ảo đang chạy trên Node chết đó sang các Node còn sống để khởi động lại.
Điều kiện để dùng được HA
- Đã có Cluster (từ 3 node trở lên để đảm bảo quorum an toàn)
- VM/CT phải nằm trên shared storage (Ceph, NFS, iSCSI...) — vì node khác cần truy cập được disk để start lại VM. VM chạy trên local storage không failover được.
- Cần cơ chế fencing/watchdog để đảm bảo node lỗi thật sự bị cô lập trước khi VM được start ở nơi khác (tránh 2 node cùng chạy 1 VM → corrupt data)
2. Cấu hình HA
2.1. Cấu hình đưa VM vào trong HA
Ta vào Datacenter → HA → Resources → Add
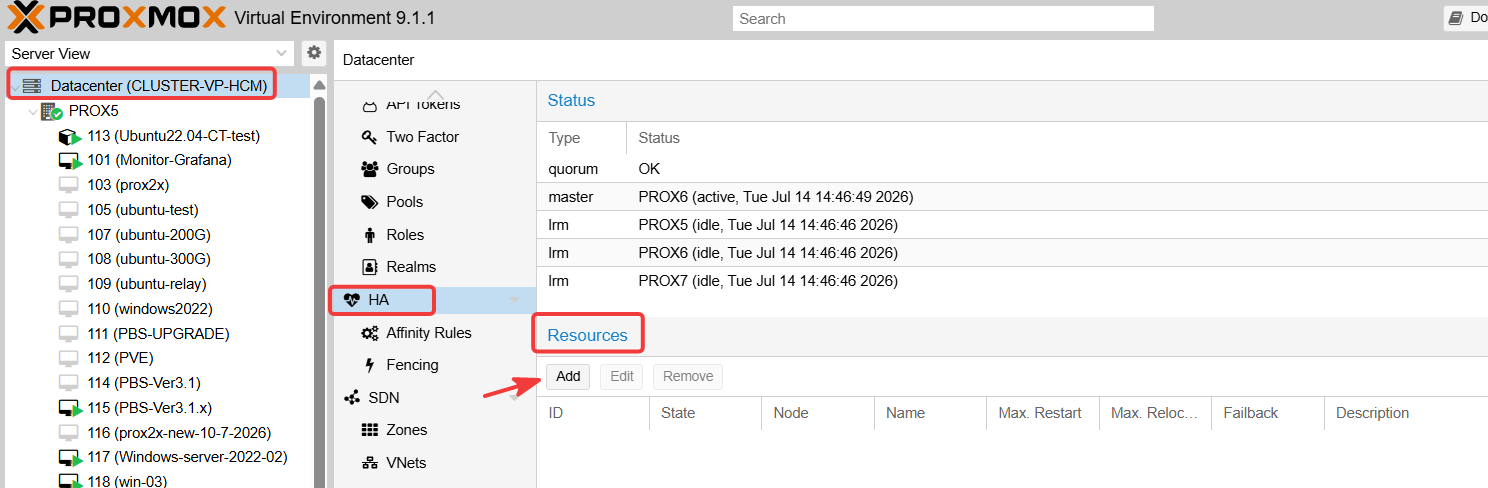
Khi ấn add xong sẽ hiện ra tab để cho ta cấu hình:
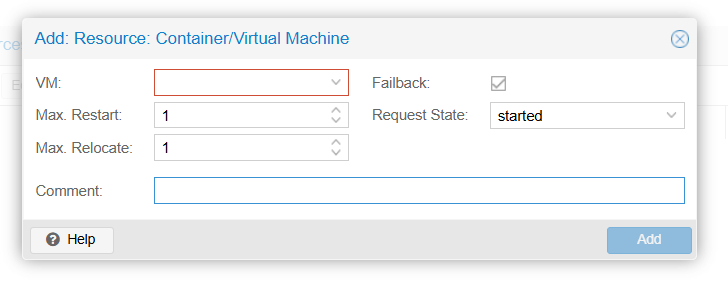
Các thông số gồm:
- VM: Nơi ta click chọn ID của Máy ảo (VM) hoặc Container (LXC) đang có trên hệ thống mà ta muốn đưa nó vào chế độ bảo vệ HA.
-
Max. Restart (Số lần thử khởi động lại tại chỗ): Khi máy ảo đang chạy trên Node hiện tại mà bị sập đột ngột (ví dụ: lỗi màn hình xanh hoặc hệ điều hành bên trong bị crash tự tắt), Proxmox HA sẽ cố gắng tự bấm nút bật lại (Start) máy ảo đó ngay tại Node cũ.
Giá trị cấu hình (1): Hệ thống sẽ chỉ thử cứu hộ tự động tại chỗ đúng 1 lần. Nếu bật lên vẫn lỗi, nó sẽ dừng lại để tránh tạo vòng lặp treo máy. -
Max. Relocate (Số lần thử dịch chuyển sang Node khác): Trong trường hợp Node vật lý chứa máy ảo bị chết hẳn phần cứng (không thể bật lại máy ảo tại chỗ được nữa), đây là số lần tối đa cụm HA được phép tự động bê cấu hình máy ảo đó chạy sang một Node vật lý khác còn sống trong Cluster để hồi sinh.
Giá trị cấu hình (1): Hệ thống sẽ chỉ thực hiện dịch chuyển cứu hộ sang Node khác duy nhất 1 lần. -
Failback (☑️ Tích chọn): Đây là tính năng tự động đưa máy ảo "về nhà cũ" sau khi sự cố được khắc phục.
Cơ chế hoạt động: Ví dụ máy ảo ban đầu chạy ở Node PVE-01. Khi PVE-01 sập, HA cứu hộ máy ảo sang PVE-02 chạy tạm. Một lúc sau, tôi sửa xong Node PVE-01 và bật nó Online trở lại cụm. Nếu tích chọn ô này, cụm HA sẽ tự động Migrate con máy ảo đó từ PVE-02 trả ngược về lại đúng Node gốc PVE-01 để đảm bảo đúng quy hoạch tài nguyên ban đầu mà ông không cần làm tay. -
Request State (Trạng thái của Máy ảo): Định nghĩa trạng thái mà cụm HA bắt buộc phải duy trì cho máy ảo này.
Giá trị cấu hình (started): Có nghĩa là máy ảo này bắt buộc phải luôn luôn bật. Bằng mọi giá, nếu nó bị tắt do lỗi hay do Node sập, HA sẽ tự động kích hoạt lệnh bật nguồn nó lên lại.
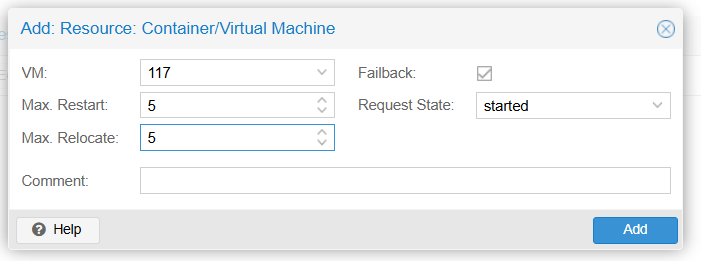
Tôi sẽ thêm như sau chẳng hạn:
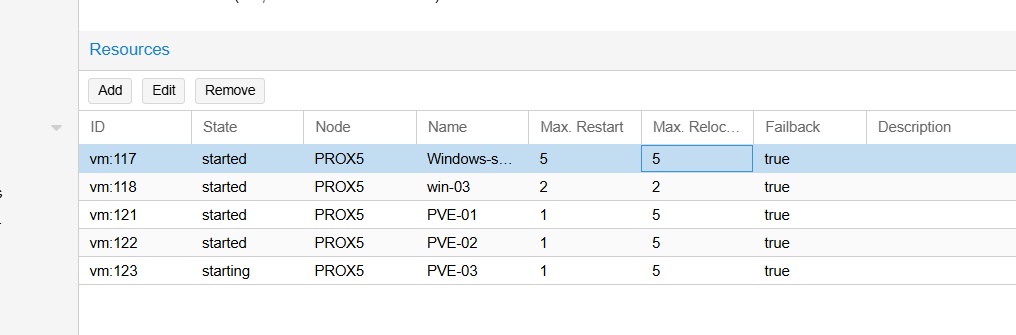
Tôi add 1 vài trên cụm cluster vào đây chằng hạn
Có thể nhóm nhiều VM cùng nhóm ưu tiên node qua Affinity Rules (thay cho HA Groups ở bản cũ 8.x — ở 9.x, cơ chế group cũ được migrate tự động sang Affinity Rules khi upgrade).
2.2. HA Node Affinity Rules (Quy tắc liên kết giữa Máy ảo và Node vật lý)
Mục này dùng để cấu hình mối quan hệ giữa Máy ảo (HA Resources) và Mạch phần cứng (Nodes vật lý). Ta dùng luật này khi muốn chỉ định một nhóm máy ảo chỉ được phép chạy hoặc ưu tiên chạy trên một số server cố định.
State (Trạng thái liên kết): Có 2 trạng thái chính:
- Affinity (Thân thiện): Ép máy ảo bắt buộc hoặc ưu tiên phải chạy trên danh sách các Node được chỉ định. (Ví dụ: Con máy ảo Windows Server ăn theo CPU của node PVE-01, tôi dùng luật này để nó chỉ luẩn quẩn ở PVE-01 thôi).
- Anti-Affinity (Cách ly): Cấm không cho máy ảo bén mảng đến các Node nằm trong danh sách đen.
Strict (Luật cứng / Luật mềm):
- Nếu chọn Strict (Luật cứng): Nếu toàn bộ các Node trong danh sách quy định bị chết sạch, Proxmox thà để máy ảo tắt hẳn chứ tuyệt đối không cho phép nó tháo chạy sang các Node khác bên ngoài.
- Nếu bỏ chọn Strict (Luật mềm): Bình thường máy ảo sẽ chạy trên các Node được chỉ định. Nhưng nếu các Node đó chết hết, luật sẽ bị phá bỏ để HA cứu hộ máy ảo sang các Node còn lại trong cụm nhằm cứu sống dịch vụ.
Cấu hình như sau:
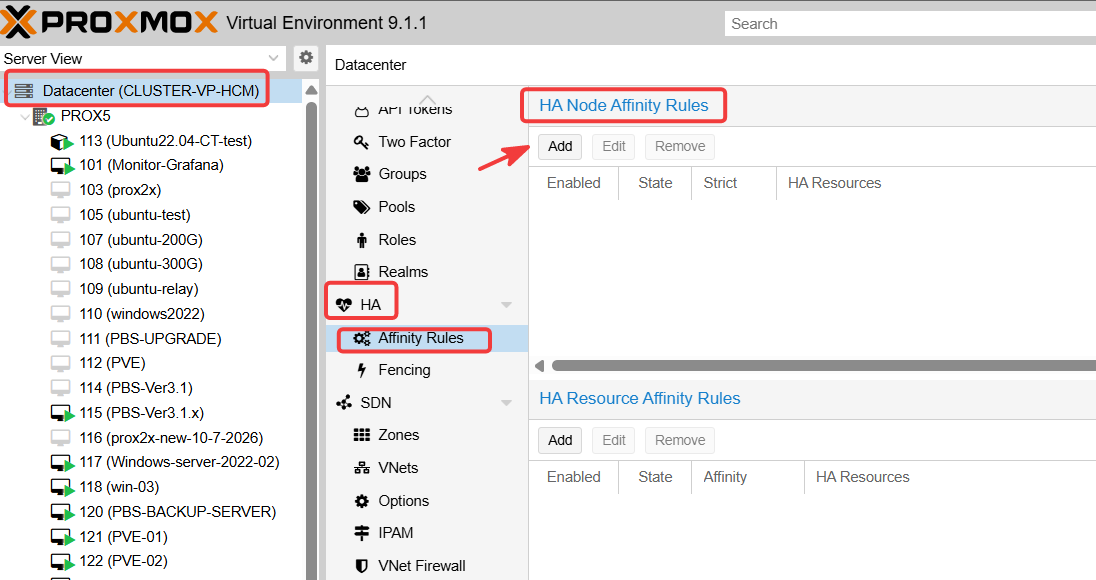
Vào Datacenter → HA → Affinity Rules → HA Node Affinity Rules → Add
VD: Tôi cấu hình như sau:
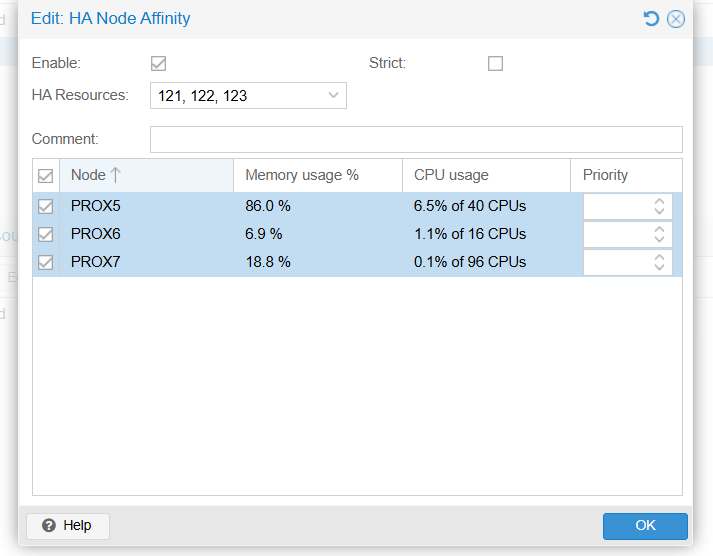
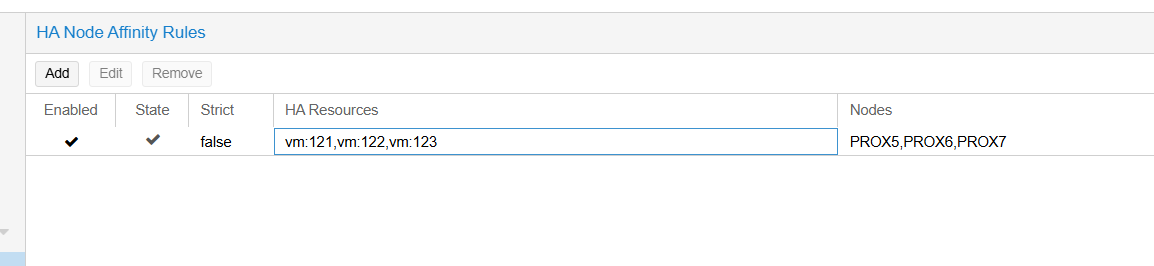
Điều này có nghĩa:
Strict: Bỏ tích, các máy ảo được chọn sẽ ưu tiên chạy trên 3 node PROX5, PROX6, PROX7. Nếu cả 3 node này đồng loạt sập, cụm HA vẫn được phép mang máy ảo đi cứu hộ ở các node khác bên ngoài (nếu cụm còn node khác).
Nếu tôi Tích chọn (Strict): Luật cứng. Máy ảo chỉ được phép sống hoặc chết trên đúng 3 node này, tuyệt đối không di trú đi đâu khác.
Tạo xong ấn add là xong
2.3. HA Resource Affinity Rules (Quy tắc liên kết giữa Máy ảo với Máy ảo)
Mục này dùng để cấu hình mối quan hệ giữa các máy ảo với nhau mà không quan tâm chúng nằm trên Node vật lý nào. Đây là tính năng sống còn để thiết kế hạ tầng chịu lỗi cao.
Affinity (Chạy chung nhóm): Gộp các máy ảo có mối liên hệ mật thiết phải nằm chung một Node vật lý để tối ưu hóa tốc độ giao tiếp nội bộ qua RAM/băng thông giữa chúng (giảm độ trễ mạng).
Anti-Affinity (Bắt buộc chia tách - Dùng nhiều nhất):
- VD: Tôi có 2 con máy ảo chạy Web Server làm nhiệm vụ cân bằng tải (Load Balancing) hoặc 2 con máy ảo chạy Database dạng Replication (đồng bộ Master-Slave).
- Nếu vô tình cả 2 con máy ảo này cùng nằm trên Node PVE-01, khi PVE-01 đột ngột chết, khách hàng sẽ sập toàn bộ dịch vụ ngay lập tức trong lúc chờ HA hồi sinh.
- Bằng cách tạo luật Anti-Affinity, Proxmox sẽ ép con Web 1 sang PVE-01, con Web 2 sang PVE-02. Node 1 có chết thì Web 2 ở Node 2 vẫn gánh tải bình thường, đạt độ sẵn sàng cao tối đa.
Cấu hình như sau:
Vào Datacenter → HA → Affinity Rules → HA Resource Affinity Rules → Add
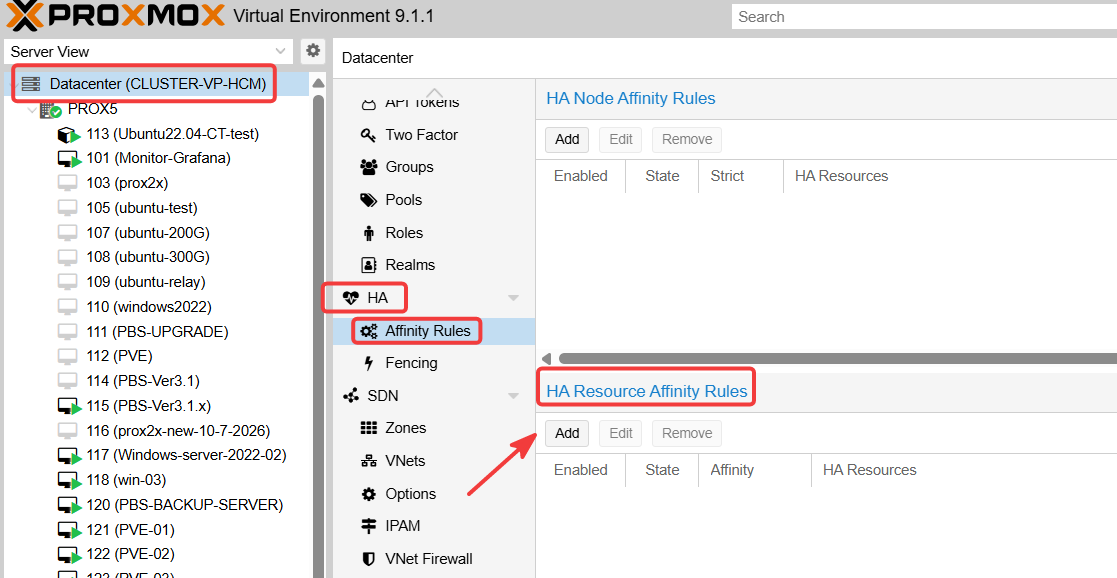
Sau khi ấn Add sẽ hiện ra 1 tab như sau:
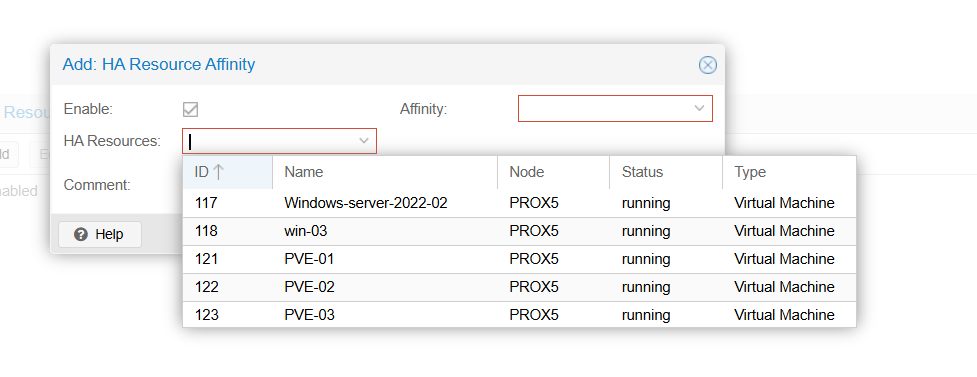
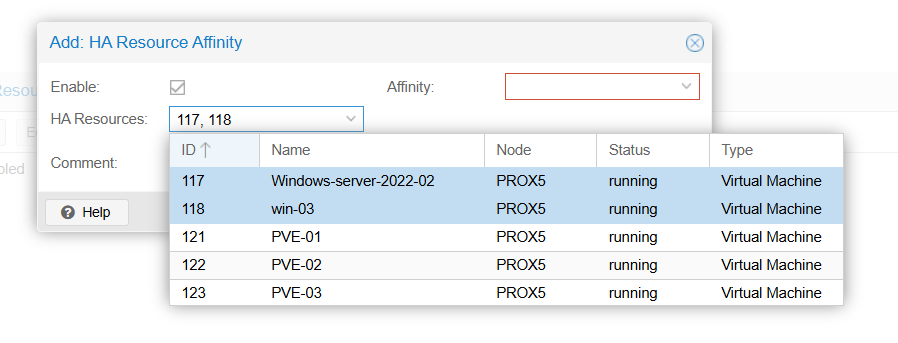
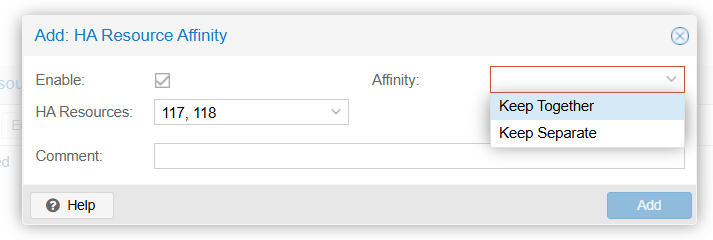
Chú ý mục Afffinity:
1. Keep Together (Gom lại ở chung)
Bản chất kỹ thuật: Ép cụm HA bằng mọi giá phải giữ cho các máy ảo trong danh sách luôn luôn chạy chung trên cùng một Node vật lý (ví dụ cùng nằm ở PROX5). Khi có sự cố cần migrate, cụm HA cũng sẽ bốc cả cụm này đi cùng nhau sang một Node khác chứ không xé lẻ ra.
Kịch bản thực tế áp dụng: Dùng cho các cặp máy ảo phụ thuộc chặt chẽ vào nhau về mặt dữ liệu và băng thông mạng.
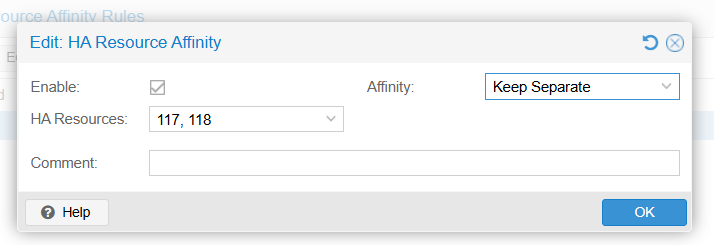
Ví dụ: Con VM 117 và VM 118 tôi sẽ như trên
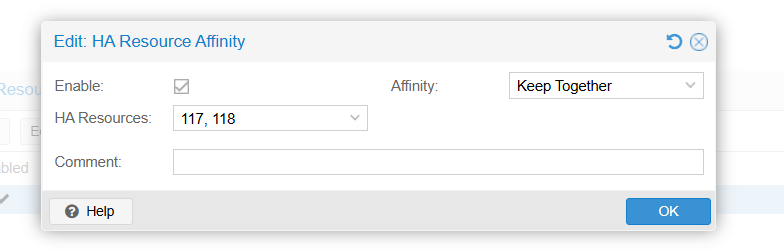
Thì cả con này sẽ luôn luôn ở chung 1 node vật lý không thể nào ở riêng được. Trường hợp này ít dùng hơn.
2. Keep Separate (Bắt buộc chia tách / Cách ly)
Bản chất kỹ thuật: Ép cụm HA tuyệt đối không được phép cho các máy ảo này nằm chung một Node vật lý. Hệ thống sẽ tự động phân bổ: ví dụ con 117 sang PROX5 thì con 118 phải sang PROX6 hoặc PROX7.
- Thực tế hay áp dụng (Dùng nhiều nhất cho Production): Dùng cho các hệ thống máy chủ chạy song song, dự phòng chịu lỗi cao (High Availability / Fault Tolerance).
- Ví dụ: Tôi dựng 2 con máy chủ Active-Directory (Domain Controller) chạy đồng bộ dữ liệu với nhau, hoặc 2 con Web Server chạy Load Balancing gánh tải cho nhau để phòng hờ rủi ro. Nếu tôi để chung một Node, lỡ Node đó sập nguồn là TÔI mất sạch cả 2 con và sập toàn bộ dịch vụ của khách hàng.
- Khi chọn Keep Separate, Proxmox sẽ ép chúng cách ly ra 2 Server vật lý khác nhau. Node này có sập thì dịch vụ của khách vẫn đứng vững trên Node còn lại.
Ta lại cấu hình như sau:
2.4. TÍNH NĂNG CRS SETTINGS (CLUSTER RESOURCE SCHEDULER) (Chỉ có trên Proxmox version mới 9.x)
Cluster Resource Scheduler (CRS) là bộ điều phối tài nguyên động cho cụm Cluster. Thay vì việc HA Manager chỉ bốc máy ảo sang Node khác một cách ngẫu nhiên hoặc chỉ dựa vào điểm Priority tĩnh khi có sự cố, CRS sẽ liên tục giám sát hiệu năng thực tế của toàn cụm để đưa ra quyết định migrate tối ưu nhất.
Ta nhấn để cấu hình:
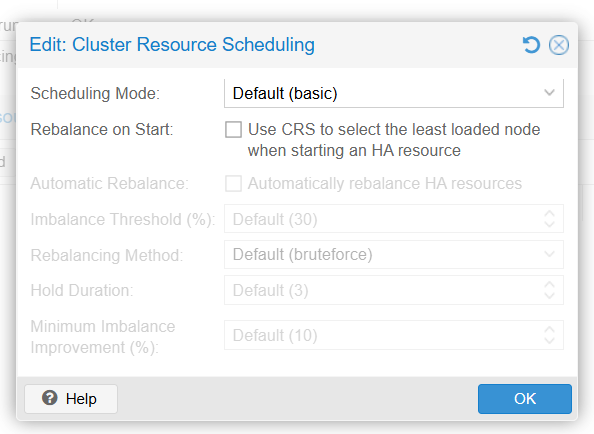
Scheduling Mode
Chọn thuật toán CRS dùng để chọn node khi 1 HA resource cần start/di chuyển:
Default (basic): Chế độ mặc định lâu đời của Proxmox. Thằng này thực chất chưa dùng đến thuật toán CRS nâng cao.
- Cách tính: Khi có sự cố HA hoặc khi bấm Start máy ảo, Proxmox chỉ kiểm tra xem Node vật lý đó có đang bị chết không, cấu hình tĩnh (RAM/CPU cấp phát) của VM có vượt quá giới hạn phần cứng của Node đó không. Nếu không vượt quá, nó sẽ chọn Node dựa theo danh sách cố định hoặc ngẫu nhiên.
- Điểm yếu: Hoàn toàn mù quáng trước tình trạng tải thực tế. Node sắp nghẽn nó vẫn có thể dồn thêm máy ảo vào.
Basic (Resource Count): Đếm đầu việc (Số lượng VM/Container) để chia bài.
- Cách tính: VD CRS sẽ quét cụm 3 Node và đếm xem mỗi Node đang gánh bao nhiêu con máy ảo (Ví dụ: PROX5 có 10 con, PROX6 có 5 con, PROX7 có 2 con). Khi có một máy ảo mới khởi động hoặc dịch chuyển, CRS sẽ tự động chọn Node có ít số lượng VM đang chạy nhất (trong trường hợp này là PROX7).
- Điểm yếu: Nó coi mọi máy ảo có tải trọng như nhau. Ví dụ 1 con VM Windows Server gánh Database siêu nặng chạy ở Node A vẫn được tính cào bằng là "1 con" giống y hệt như 1 con VM Linux tí hon chạy script nhẹ nhàng ở Node B.
Static Load (Tải tĩnh theo cấu hình): Tính toán dựa trên tổng phần cứng được cấp phát trên lý thuyết.
- Cách tính: CRS không thèm đếm số lượng VM nữa, mà nó cộng tổng số vCPU và tổng dung lượng RAM ông đã cấu hình cho các VM trên Node đó.
- Ví dụ: PROX5 đang chứa 3 con VM, mỗi con tôi cấp 8 vCPU → Tổng tải tĩnh là 24 vCPU. PROX6 chứa 5 con VM, nhưng mỗi con chỉ được cấp 2 vCPU →Tổng tải tĩnh là 10 vCPU. CRS sẽ ưu tiên đẩy VM mới sang PROX6 vì tổng tài nguyên lý thuyết được cấp phát ở đây còn dư dả hơn.
- Ưu điểm: Rất an toàn để tránh việc cấu hình vượt ngưỡng quá đà (Overcommit) phần cứng trên một Node.
- Điểm yếu: Vẫn chưa phản ánh đúng thực tế. Nhiều khi Admin cấp cho VM 8 vCPU nhưng thực tế khách hàng chỉ xài có 5% CPU, Node đó vẫn đang cực kỳ rảnh nhưng mode này lại tính là nó đang nặng tải.
Dynamic Load (Tải động thực tế - Khuyên dùng): Đây mới là mode ngon nhất của CRS (Cân bằng tải thời gian thực - Real-time).
Cách tính: CRS sẽ liên tục đọc số liệu giám sát (Metrics) từ hệ thống. Nó nhìn vào mức độ ngốn CPU thực tế (%) và dung lượng RAM thực tế (GB) mà các máy ảo đang thực sự chiếm dụng trên phần cứng ngay tại thời điểm đó để ra quyết định.
Ưu điểm: Khắc phục hoàn toàn điểm yếu của 3 mode trên. Giả sử PROX5 của tôi dù chỉ chạy ít VM nhưng RAM thực tế đã vọt lên 86%, CRS Dynamic Load sẽ biết ngay Node này đang "thở oxy" và tuyệt đối không nhét thêm VM nào vào đây nữa, thay vào đó nó sẽ chọn PROX7 (đang trống trải CPU 0.1%, RAM 18.8%).
Lưu ý: Khi chọn mode này, ta nên cân nhắc bật tính năng Automatic Rebalance ở bên dưới để hệ thống tự động Live Migrate dọn tải cho nhau khi có Node bị thắt nút cổ chai.
Ta nên tick chọn vào options Dynamic Load để đạt hiệu quả cao nhất
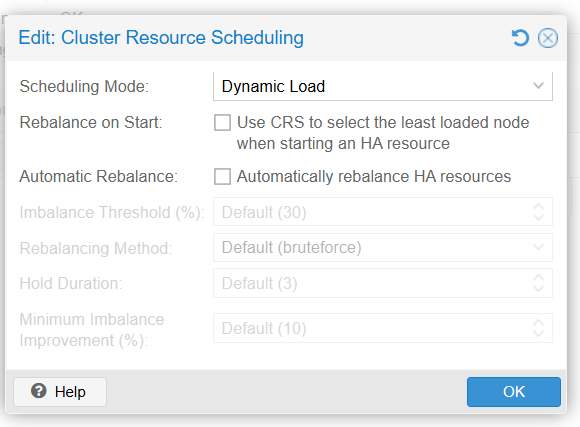
Rebalance on Start (Cân bằng lại khi khởi động):
- Cơ chế: Khi ta tích chọn ô này, mỗi khi có một máy ảo trong HA được bật lên từ trạng thái tắt, hoặc khi nó bị sập và khởi động lại (Failover), CRS sẽ lập tức quét xem tại đúng thời điểm đó, Node vật lý nào trong cụm đang rảnh nhất về CPU/RAM thực tế để ném máy ảo vào.
- Lợi ích: Tránh việc dồn ứ nhiều máy ảo vào một Node ngay lúc khởi động, giúp phân bổ tải đều ra ngay từ đầu.
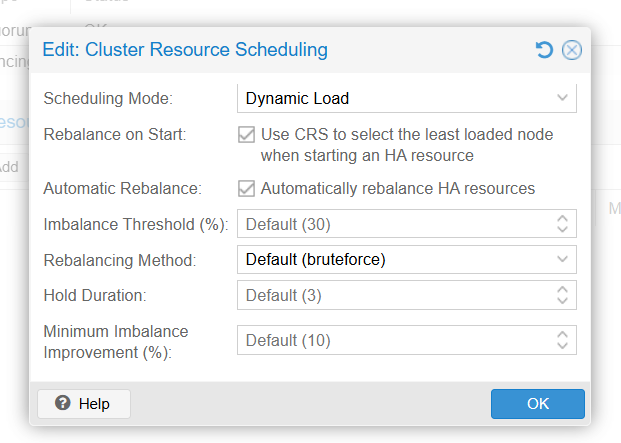
Automatic Rebalance (Tự động tái cân bằng động): khi tôi tích chọn ô này, Proxmox sẽ mở khóa toàn bộ các thông số nâng cao bị mờ ở phía dưới. Đây là tính năng tự động hóa hoàn toàn:
Imbalance Threshold (%) - Ngưỡng mất cân bằng (Mặc định 30%):
- CRS sẽ liên tục tính toán độ lệch tải thực tế giữa các Node. Nếu mức độ chênh lệch tải CPU hoặc RAM giữa Node bị nặng nhất và Node rảnh nhất vượt quá con số này (ví dụ một bên ngốn 80%, một bên chỉ có 40% → lệch 40%, vượt ngưỡng 30%), hệ thống sẽ kích hoạt bộ lọc tìm giải pháp.
Rebalancing Method - Phương thức tính toán (Mặc định bruteforce):
- Bruteforce: Proxmox sẽ chạy thuật toán quét qua mọi kịch bản migrate có thể xảy ra cho tất cả các máy ảo nhằm tìm ra phương án tối ưu nhất để hạ tải đều cho cụm.
Hold Duration - Thời gian neo giữ (Mặc định 3 phút):
- Đây là bộ lọc giảm nhiễu cực kỳ hay. Nó bắt buộc tình trạng quá tải/lệch tải vượt ngưỡng phải kéo dài liên tục trong vòng 3 phút thì mới cho phép thực hiện Live Migrate.
- Điều này giúp hệ thống không bị "hiểu sai", tránh việc máy ảo vừa mới đỉnh tải tức thời (Spike) trong vài giây rồi hạ xuống mà hệ thống đã vội vàng bê đi, gây tốn băng thông mạng một cách vô ích.
Minimum Imbalance Improvement (%) - Mức cải thiện tối thiểu (Mặc định 10%):
- Trước khi quyết định bấm nút Live Migrate tự động, CRS sẽ tính toán xem: "Nếu ta chuyển con VM này đi, độ cân bằng của toàn cụm có tốt lên được ít nhất 10% so với hiện tại không?".
- Nếu chuyển đi mà cụm chỉ tốt hơn được 2-3%, CRS sẽ hủy lệnh để tiết kiệm tài nguyên hệ thống, tránh việc chuyển dịch máy ảo vô tội vạ mà không đem lại hiệu quả rõ rệt.
Tôi cấu hình như sau để tối ưu cho cluster của mình:
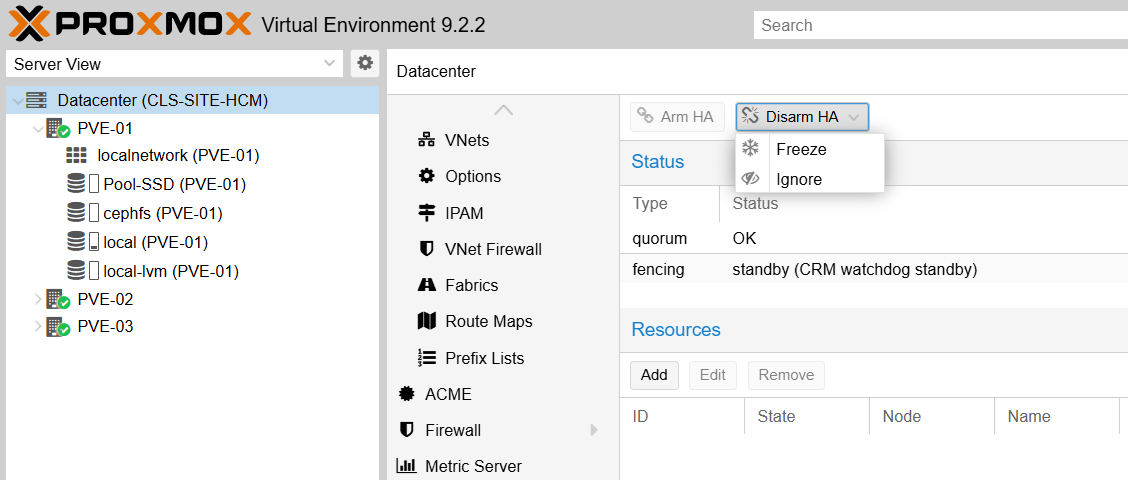
3. Disarm HA (Disable HA)
Ngày xưa muốn bảo trì hệ thống lớn là chúng ta phải mò vào từng con VM tắt HA, hoặc gõ lệnh SSH trên host proxmox để stop dịch vụ pve-ha-lrm, pve-ha-crm thì bây giờ Proxmox cho chúng ta bấm một phát ăn ngay trên Web UI.
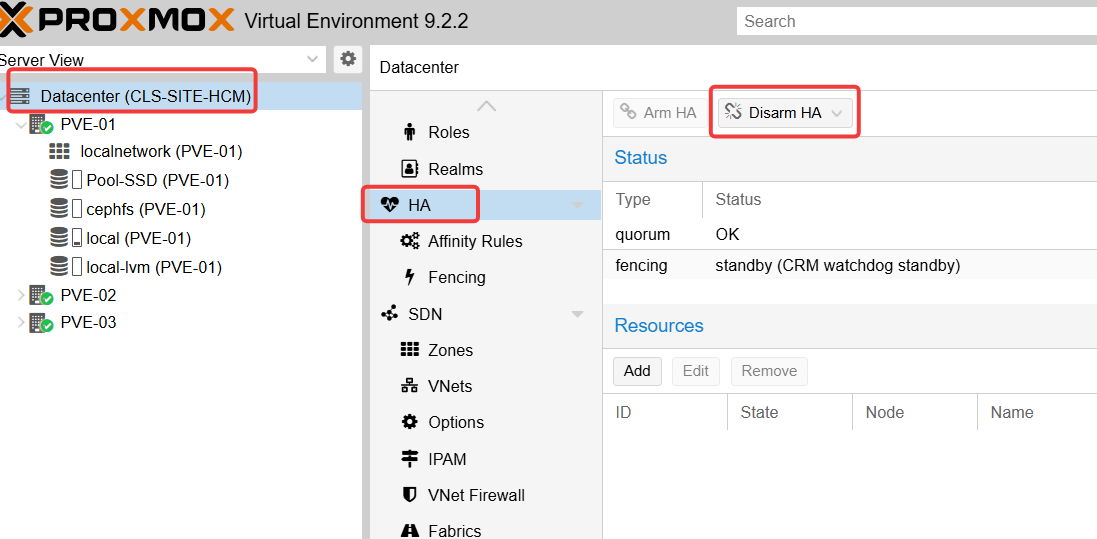
Khi ta cái nút Disarm HA này ra, nó có 2 chế độ đóng ngắt cực kỳ quan trọng:
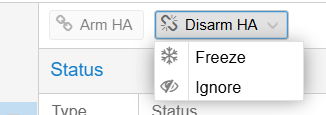
1. Freeze (Đóng băng toàn cụm HA)
Đây là chế độ dùng nhiều nhất và an toàn nhất khi bảo trì hạ tầng lớn.
- Bản chất kỹ thuật: Khi chọn Freeze, Proxmox sẽ "đóng băng" trạng thái của tất cả các máy ảo đang chạy HA. Dịch vụ HA Manager sẽ ngừng quét, ngừng tính toán, và tuyệt đối không thực hiện bất kỳ hành động tự động nào (không tự Migrate, không tự Failover hồi sinh máy, và không kích hoạt cơ chế Fencing/Watchdog tự cắm đầu reset sập nguồn máy chủ vật lý).
- Kịch bản thực tế hay áp dụng: Khi ông cần bảo trì hệ thống mạng cốt lõi (Core Switch), nâng cấp disk hay thay disk trong cụm storage (Ceph), hoặc khởi động lại (Reboot) đồng loạt các Node vật lý.
Tại sao phải dùng? Bình thường lỡ Switch mạng bị ngắt vài giây để up firmware, cụm HA sẽ tưởng các Node bị chết và lập tức kích hoạt lỗi Fencing (tự quật sập Server vật lý để cứu data), gây thảm họa cho hệ thống. Khi ông chọn Freeze, ông có tắt Switch hay rút dây mạng thoải mái, cụm HA vẫn đứng im thin thít chờ ông bảo trì xong.
2. Ignore (Bỏ qua giám sát lỗi)
- Bản chất kỹ thuật: Ở chế độ này, HA Manager vẫn chạy nhưng nó sẽ hoàn toàn nhắm mắt làm ngơ (bỏ qua) trước mọi trạng thái lỗi của các máy ảo (HA Resources). Nếu một con VM đang chạy bị crash, bị tắt đột ngột hoặc bị lỗi, HA sẽ không can thiệp, không tự bật lại cũng không tự di trú sang Node khác.
- Kịch bản thực tế áp dụng: Dùng khi ông cần can thiệp sâu, cấu hình lại, hoặc sửa lỗi hàng loạt hệ điều hành (OS) của các con máy ảo chạy dịch vụ cho khách hàng, tránh việc hệ thống HA tưởng máy ảo bị chết rồi cứ nhảy vào tranh chấp quyền khởi động lại với Admin.
Tôi cần bảo trì chỉ việc ấn vào Freeze là được.
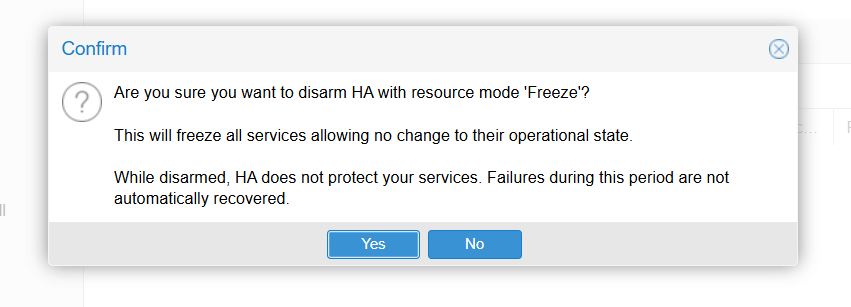
Chọn yes.
Trong bài viết này tôi sẽ demo cơ bản cho bạn đọc về việc HA hoạt động như thế nào khi cluster bị sự cố.
Lưu ý: trong quá trình vận hành lỗi gặp có thể khác nhau, các bạn nên tìm hiểu kĩ lỗi (lên các diễn đàn, nhờ hãng hỗ trợ nếu là bản license) rồi mới đưa phương án giải quyết.
1. Vấn đề
Khi một node trong Cluster Proxmox đột ngột mất kết nối (lỗi phần cứng, sập nguồn, mất mạng), HA sẽ không lập tức bê máy ảo sang node khác ngay giây đầu tiên, mà nó vận hành theo một quy trình cực kỳ nghiêm ngặt qua 3 trạng thái chính:
1. Đồng thuận số đông (Quorum)
-
Điều kiện tiên quyết để HA hoạt động là Cluster phải giữ được Quorum (tức là số lượng node còn sống phải chiếm > 50% tổng số vote của Cluster).
- Nếu Cluster bị mất Quorum (ví dụ cluster có 2 node mà chết mất 1 node), tính năng HA sẽ bị "đóng băng" để bảo vệ an toàn dữ liệu, tránh tình trạng Split-Brain.
2. Phát hiện lỗi và Đếm thời gian (Fencing & Timeout)
-
Khi một node không còn phản hồi qua mạng Corosync, Proxmox HA Manager sẽ đợi một khoảng thời gian (mặc định khoảng 1 phút) để chắc chắn node đó đã thực sự chết chứ không phải bị lag mạng tạm thời.
- Tiếp theo, cơ chế Fencing (Watchdog) sẽ được kích hoạt để đảm bảo node lỗi kia bị cô lập hoàn toàn (tự động reboot hoặc tắt hẳn phần cứng) trước khi các node còn lại nhảy vào tranh giành quyền kiểm soát ổ đĩa.
3. Migrate và Restart (Failover)
-
Sau khi xác nhận node lỗi đã an toàn (đã bị Fence), CRM (Cluster Resource Manager) trên các node còn sống sẽ tiếp quản các máy ảo (VM/CT) đã được cấu hình HA trên node chết đó.
- Các VM này sẽ được khởi động lại từ đầu (Cold Boot) trên các node mới bằng cách đọc dữ liệu từ vùng lưu trữ chung (Shared Storage như Ceph, NFS, SAN).
2. Kịch bản testing HA
Điều kiện cần:
-
Cluster: Có ít nhất 3 node vật lý (hoặc ảo hóa lồng) để đảm bảo khi 1 node chết, 2 node còn lại vẫn giữ được Quorum (> 50%).
-
Shared Storage: Máy ảo test bắt buộc phải nằm trên ổ đĩa dùng chung (ví dụ: Ceph, NFS, iSCSI). Nếu nằm trên ổ đĩa cục bộ (Local Storage), HA sẽ không thể chạy được vì node khác không thể đọc được đĩa.
- HA Resource: Máy ảo test đã được thêm vào mục Datacenter -> HA với trạng thái started.
Tôi chuẩn cụm 1 lab có 3 node như hình bên dưới:
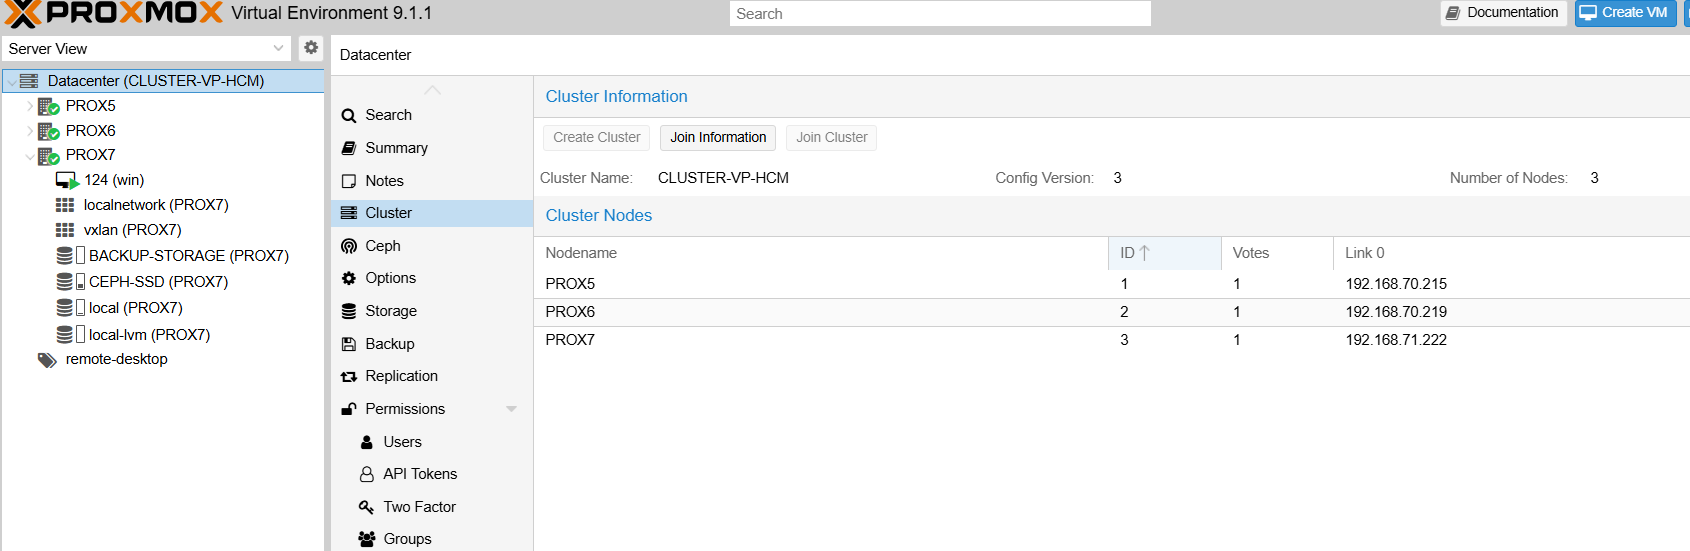
Tạo 2 con VM windows trên Prox7, lát nữa tôi sẽ giả lập tình huống nếu như Prox7 bị down thì VM sẽ tự động khởi động trên 2 node còn lại.
Trước tiên kiểm tra sơ qua các điều kiện:
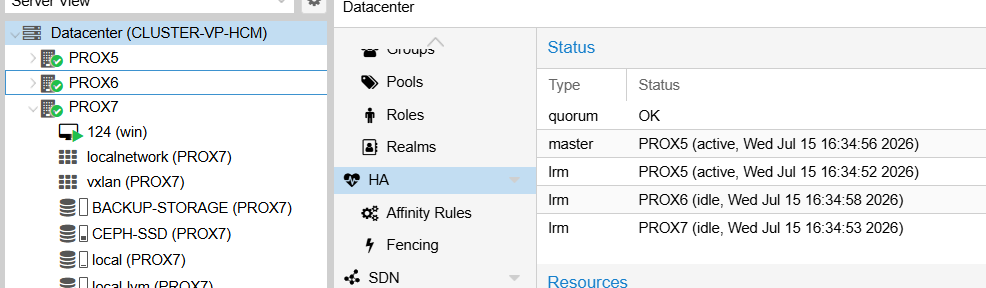
1. Hiện cụm đã có 3 host, trạng thái quorum ok
2. Storage sử dụng của VM là Ceph là shard storage thõa điều kiện
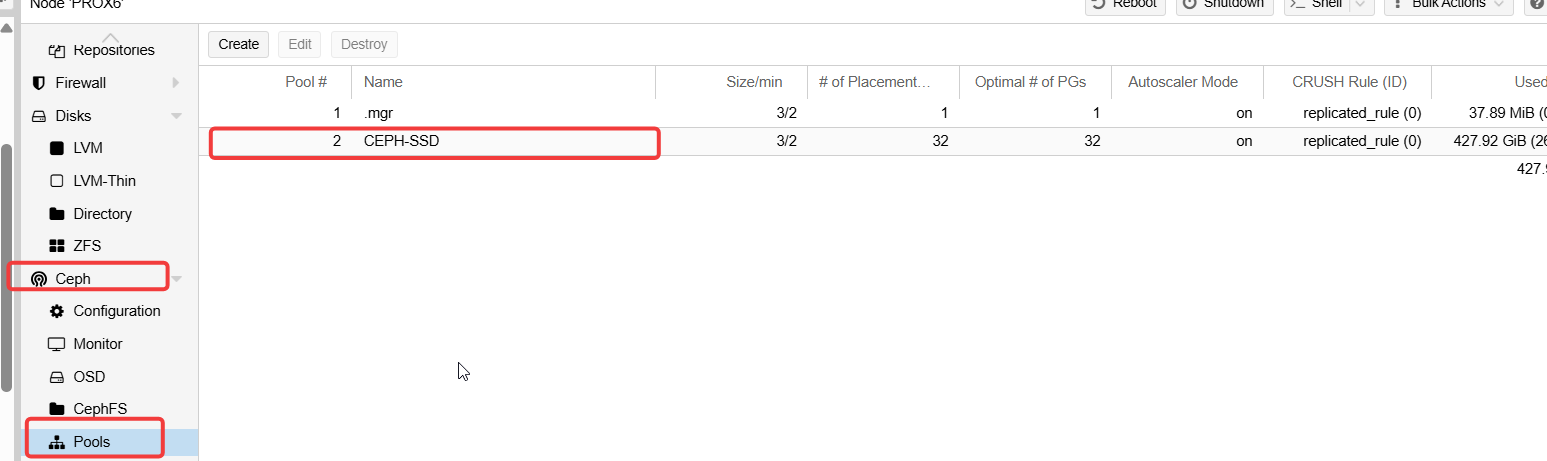
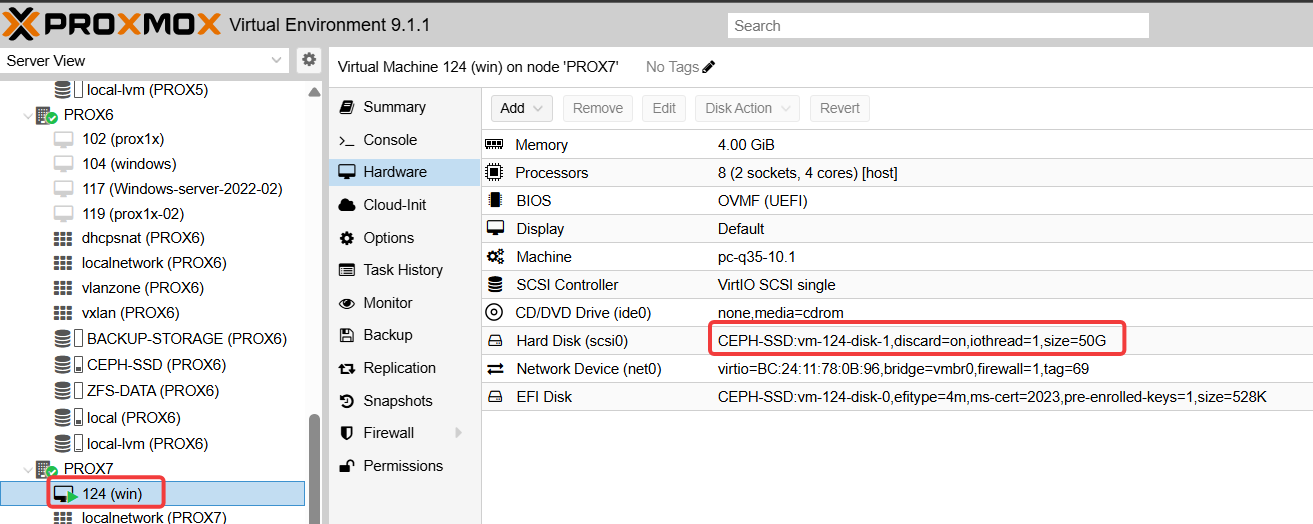
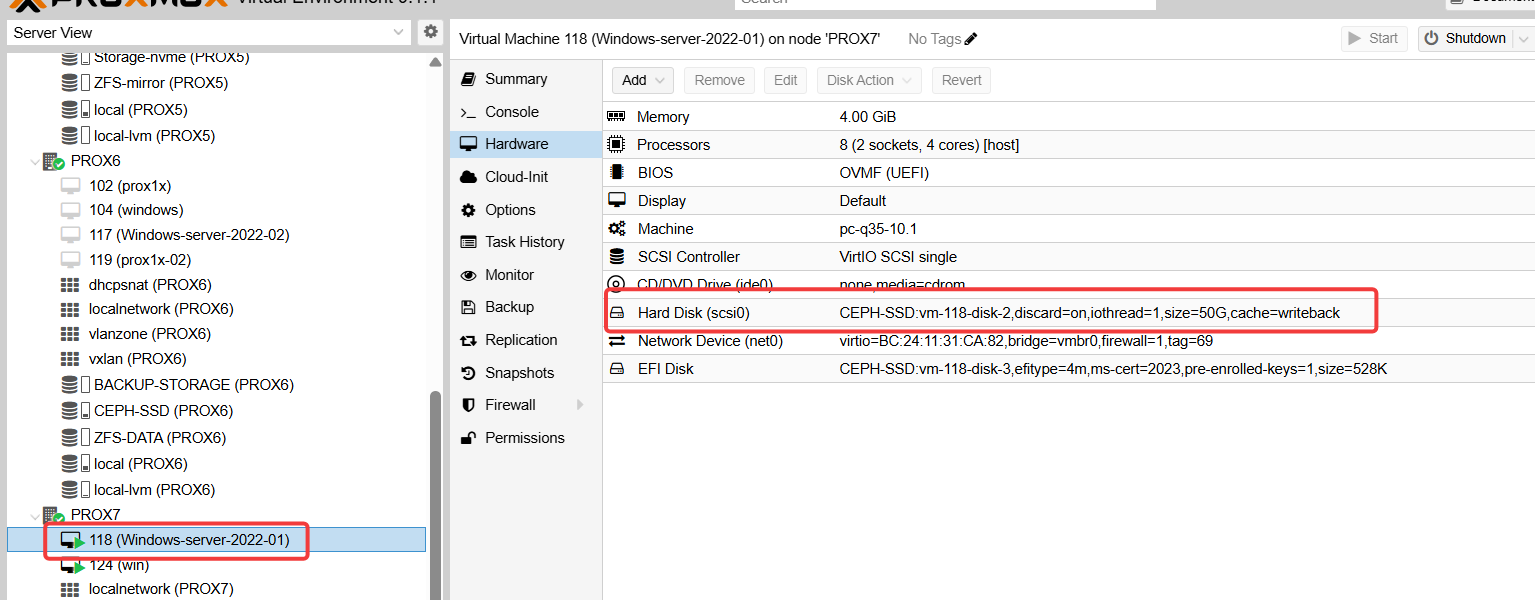
Đảm bảo Ceph ở trạng thái ổn nhất
Đảm bảo số lượng MON luôn là số lẻ, và nhiều (TH này 3 node thì 3 MON là hợp lí → luôn bầu chọn được)
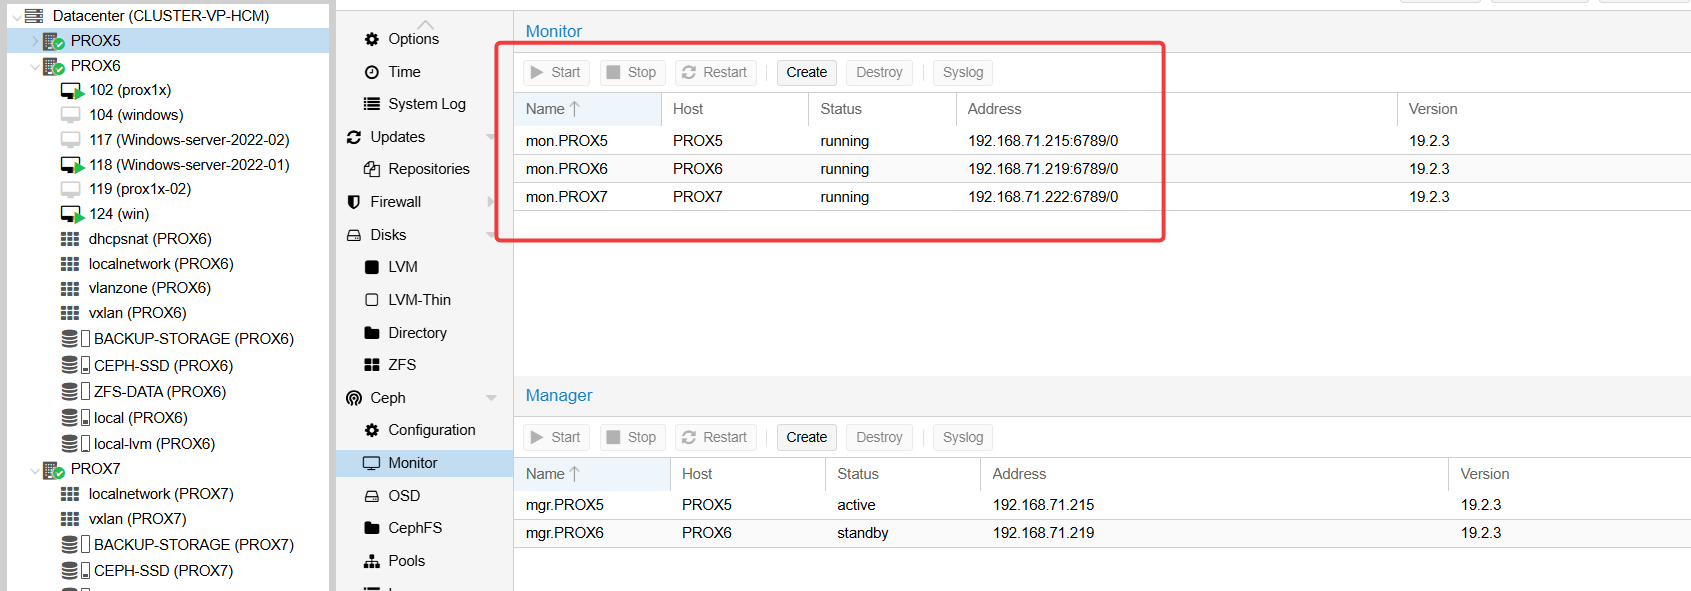
3. Add VM vào HA
Ta làm như sau:
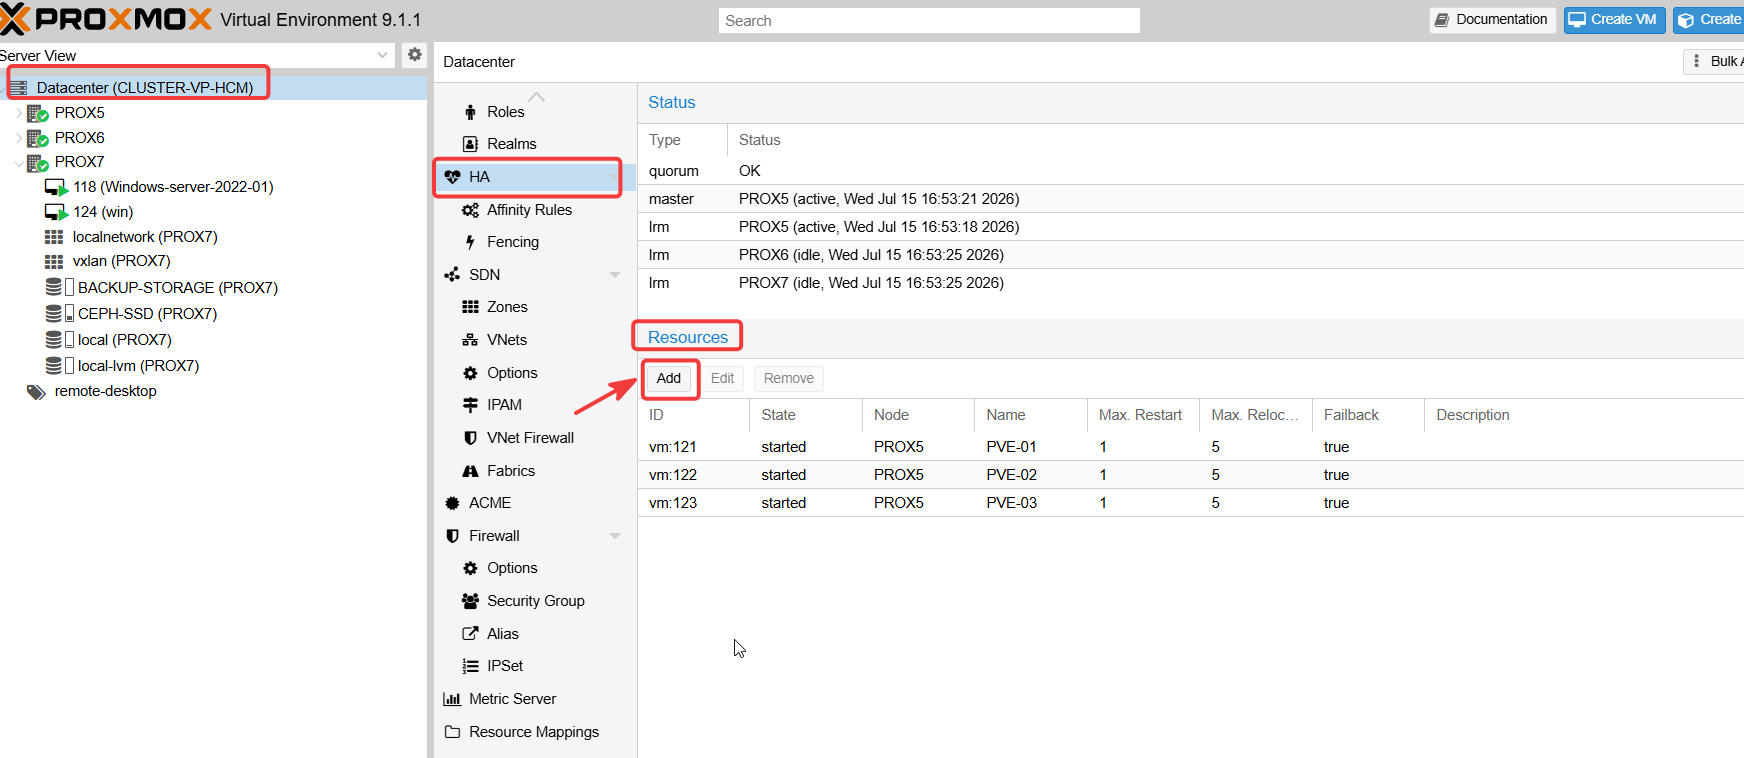
Add 2 VM vào HA
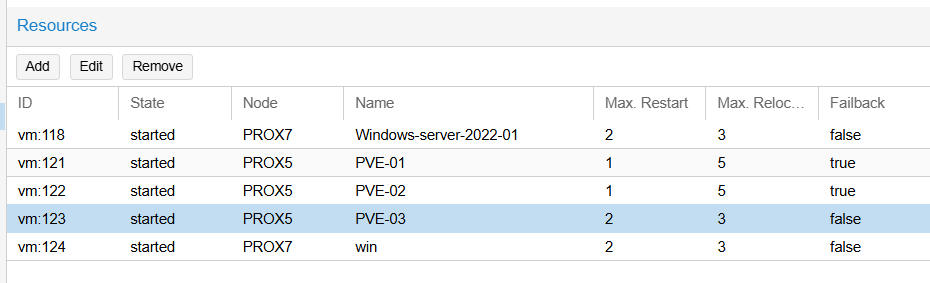
Khi tôi cấu hình như trên: Cơ chế mặc định của Proxmox HA khi tôi không cấu hình gì ở mục dưới (Affinity Rules), hệ thống sẽ tự hiểu là "VM này có thể nhảy sang bất kỳ host nào còn sống trong Cluster".
Các mục cấu hình nâng cao khác bạn đọc tự tìm hiểu và cấu hình testing thêm. Tham khảo thêm phần “Tính năng HA trên Proxmox Cluster” mục 8.5
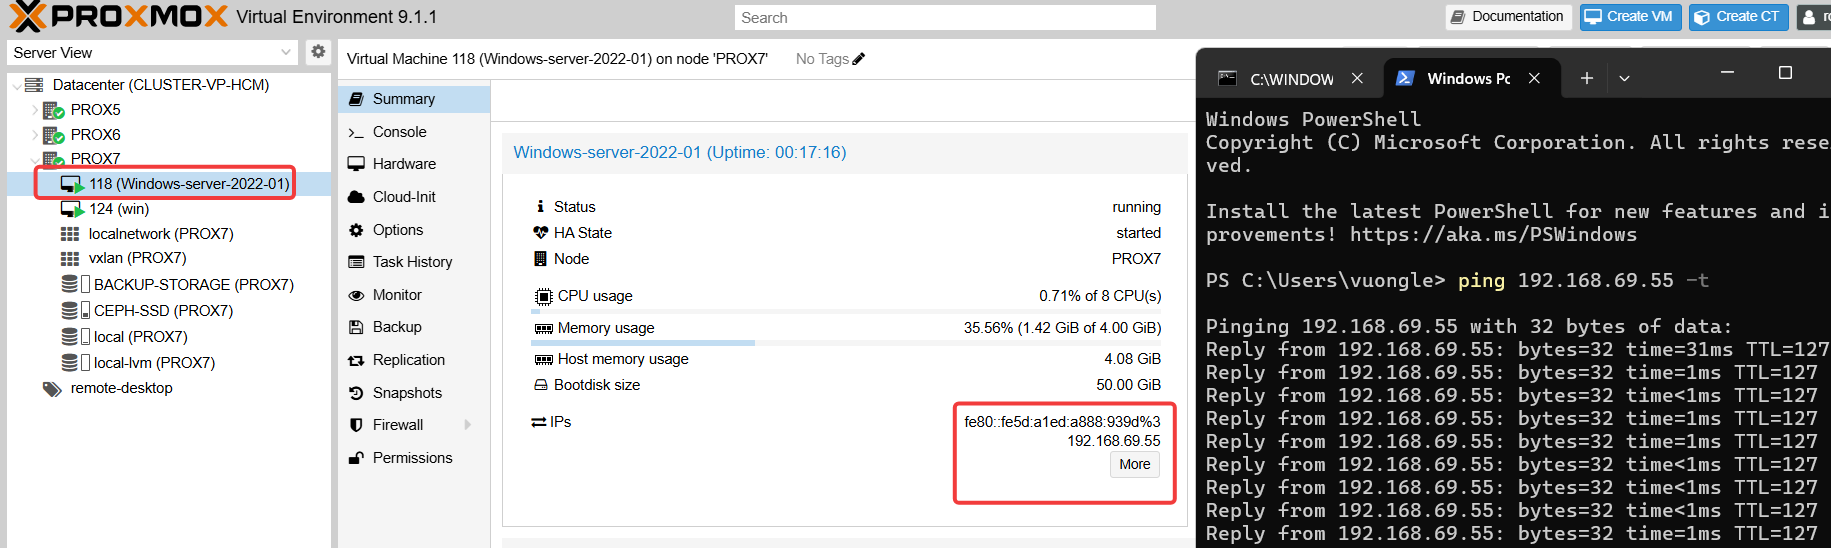
Treo ping test
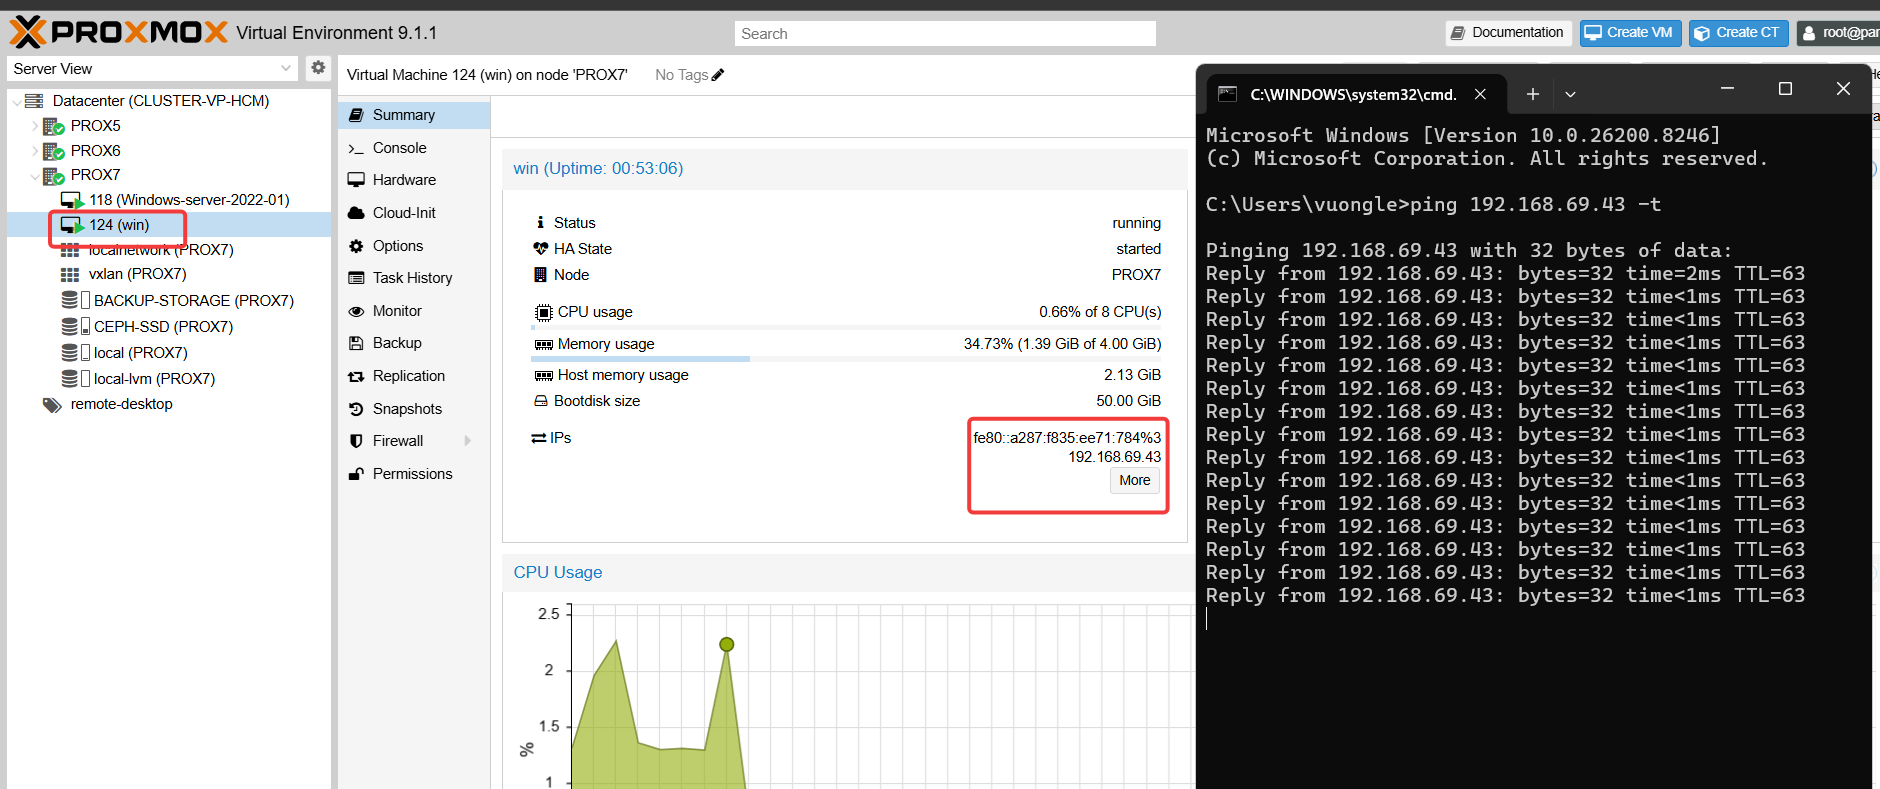
Hiện tại 2 VM đang kết nối bình thường
Bây giờ tôi sẽ OFF PROX7 để kích hoạt cơ chế HA này
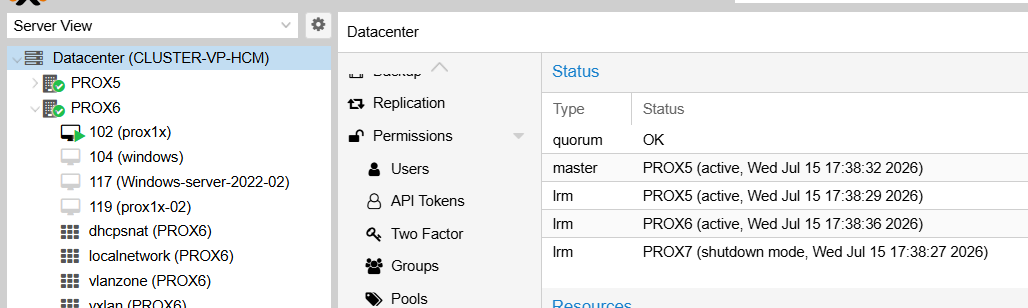
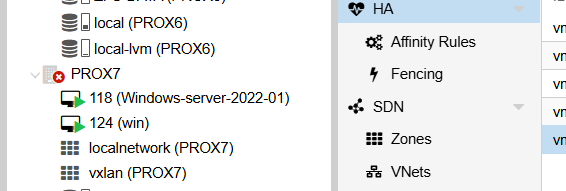
Biểu tượng node PROX7 lập tức đổi sang dấu X đỏ báo hiệu mất kết nối mạng. Trong bảng HA Status, trạng thái của PROX7 được ghi nhận ban đầu là shutdown mode (hoặc bắt đầu mất tín hiệu heartbeat). Hai node còn lại (PROX5 và PROX6) vẫn giữ trạng thái quorum OK và cùng bầu PROX5 làm master điều phối cứu hộ.
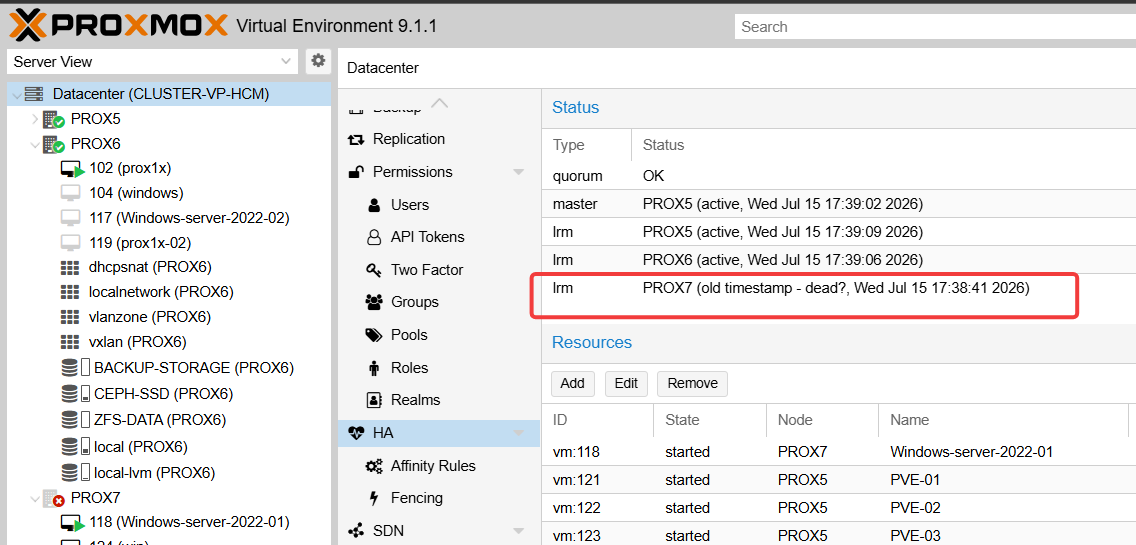
Dòng trạng thái chuyển sang: PROX7 (old timestamp - dead?, ...).
Đây là lúc HA Manager phát hiện ra node PROX7 đã quá thời gian cập nhật time-stamp (thường là sau khoảng 1 phút mất kết nối liên tục). Hệ thống chính thức gắn nhãn nghi ngờ node này đã chết hoàn toàn (dead?).
Lúc này Ceph nhờ có đủ quorum nên vẫn giữ đĩa ảo an toàn, không block I/O. Hệ thống chuẩn bị ra quyết định kích hoạt hàng rào bảo vệ (Fencing) và dịch chuyển hạ tầng.
Các VM khi node Prox7 off VM bị mất kết nối tạm thời (Request timed out)
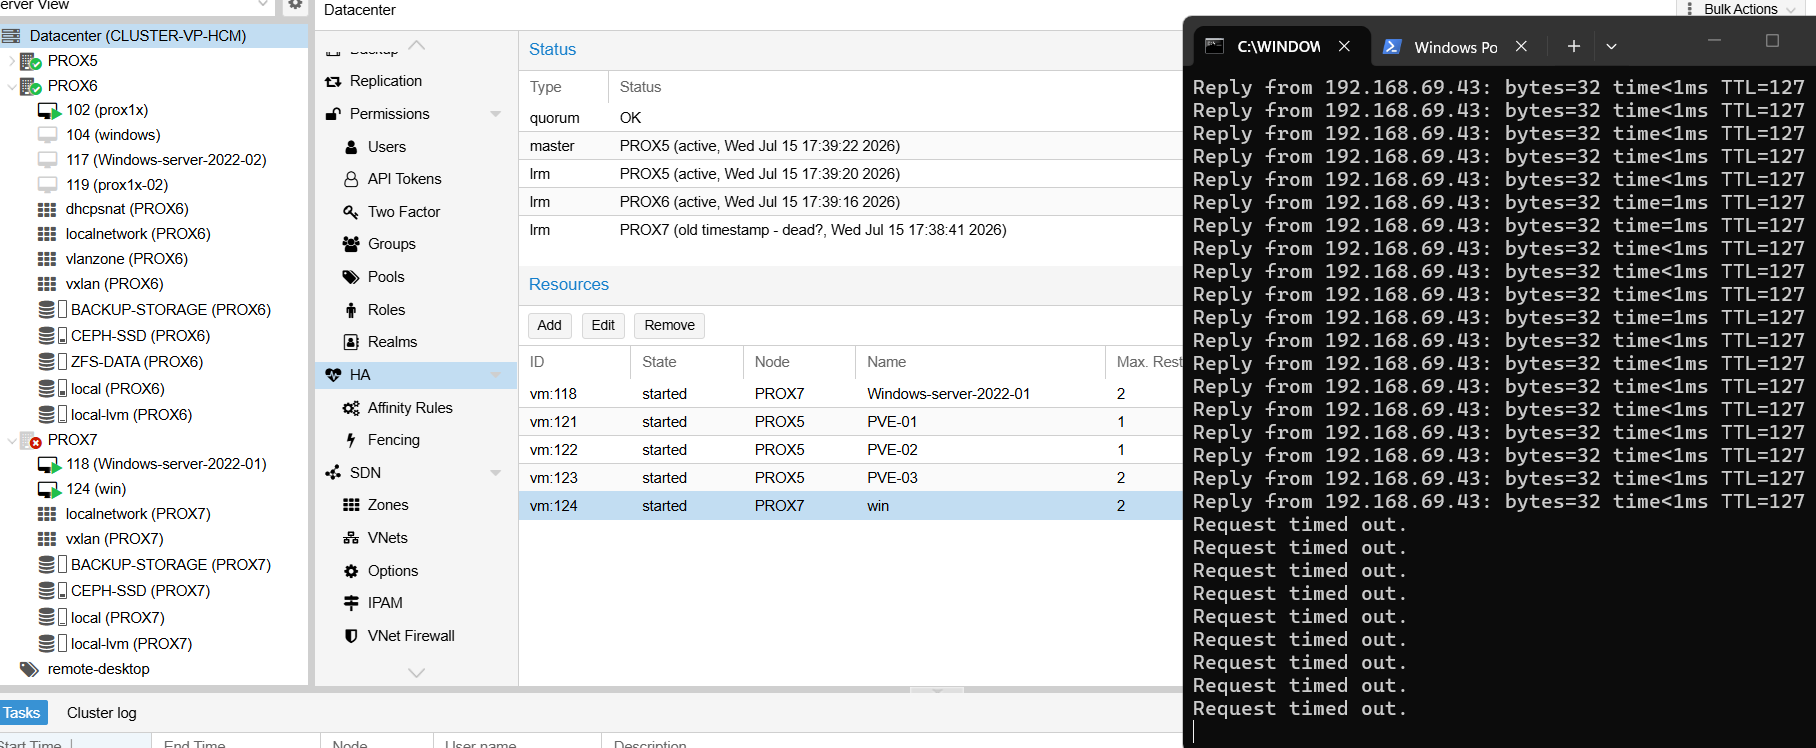
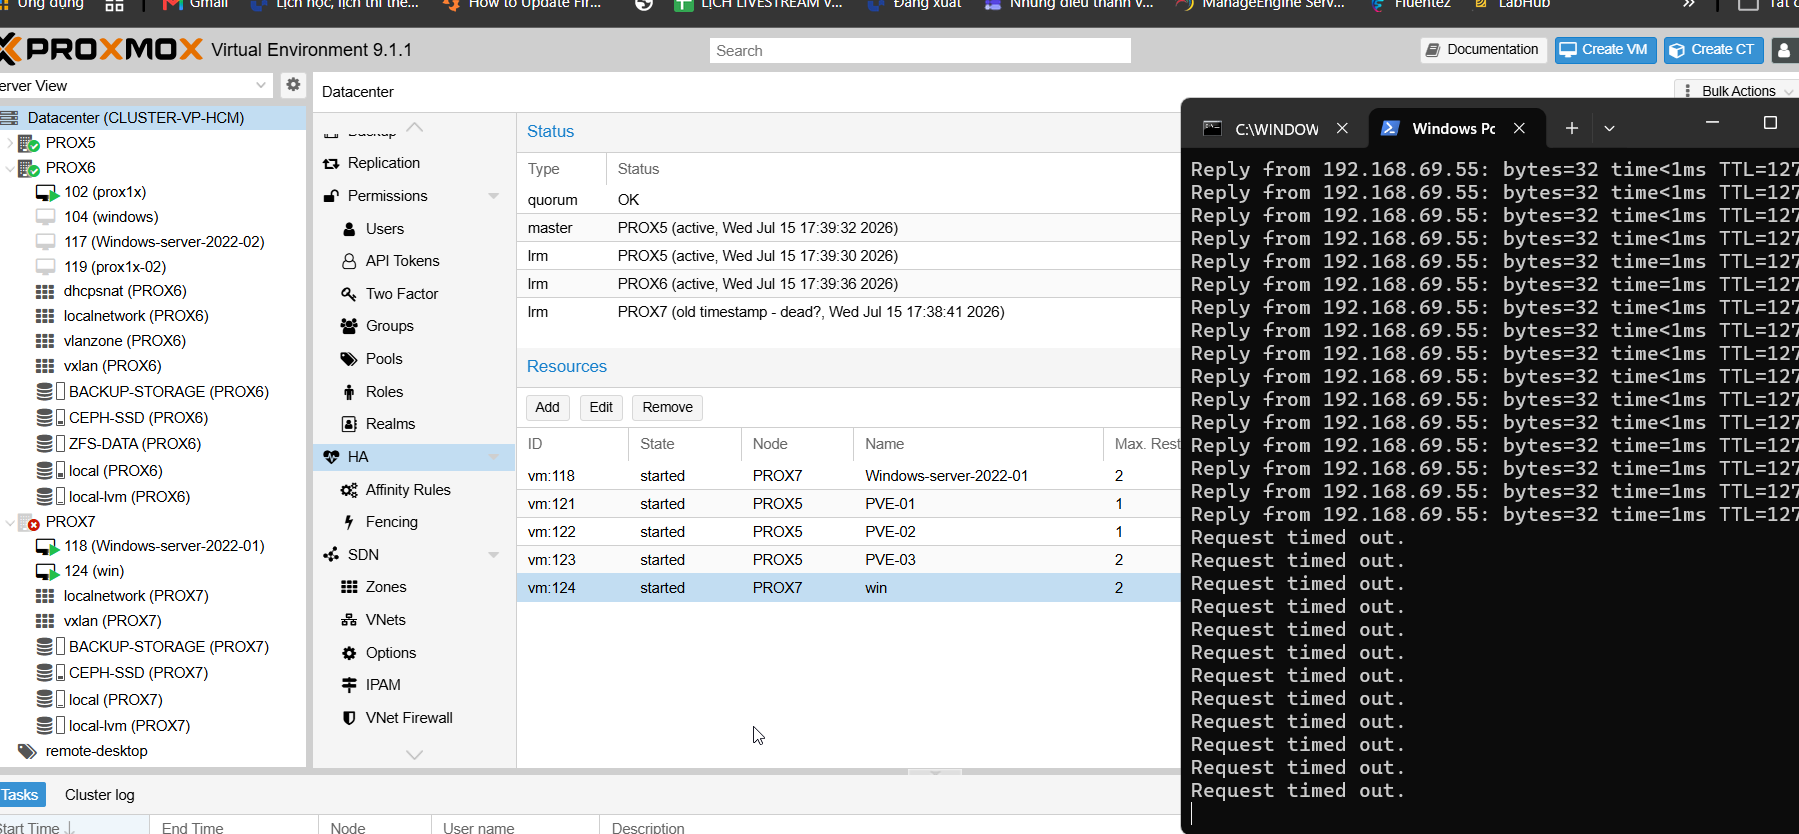
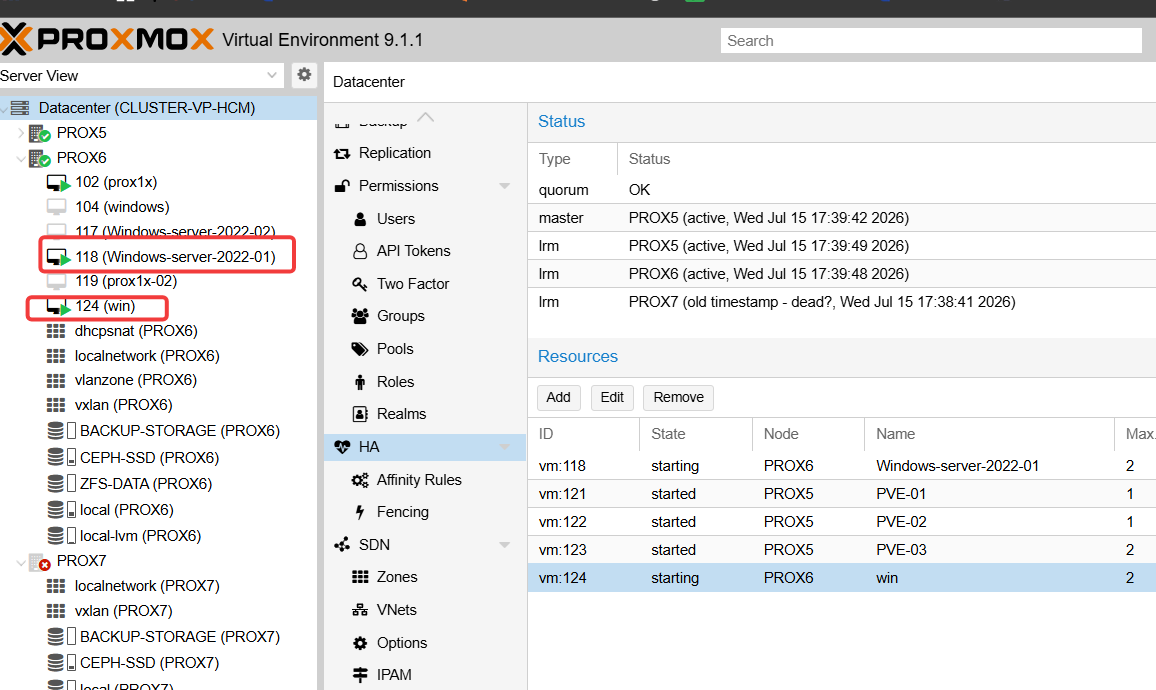
Sau khi xác nhận PROX7 (old timestamp - dead?), HA Manager lập tức thực hiện Fencing node chết và migrate lại hai con VM 118 và 124 sang bên host PROX6. Trạng thái của 2 VM chuyển từ started (bên node cũ) sang starting (bên node mới).
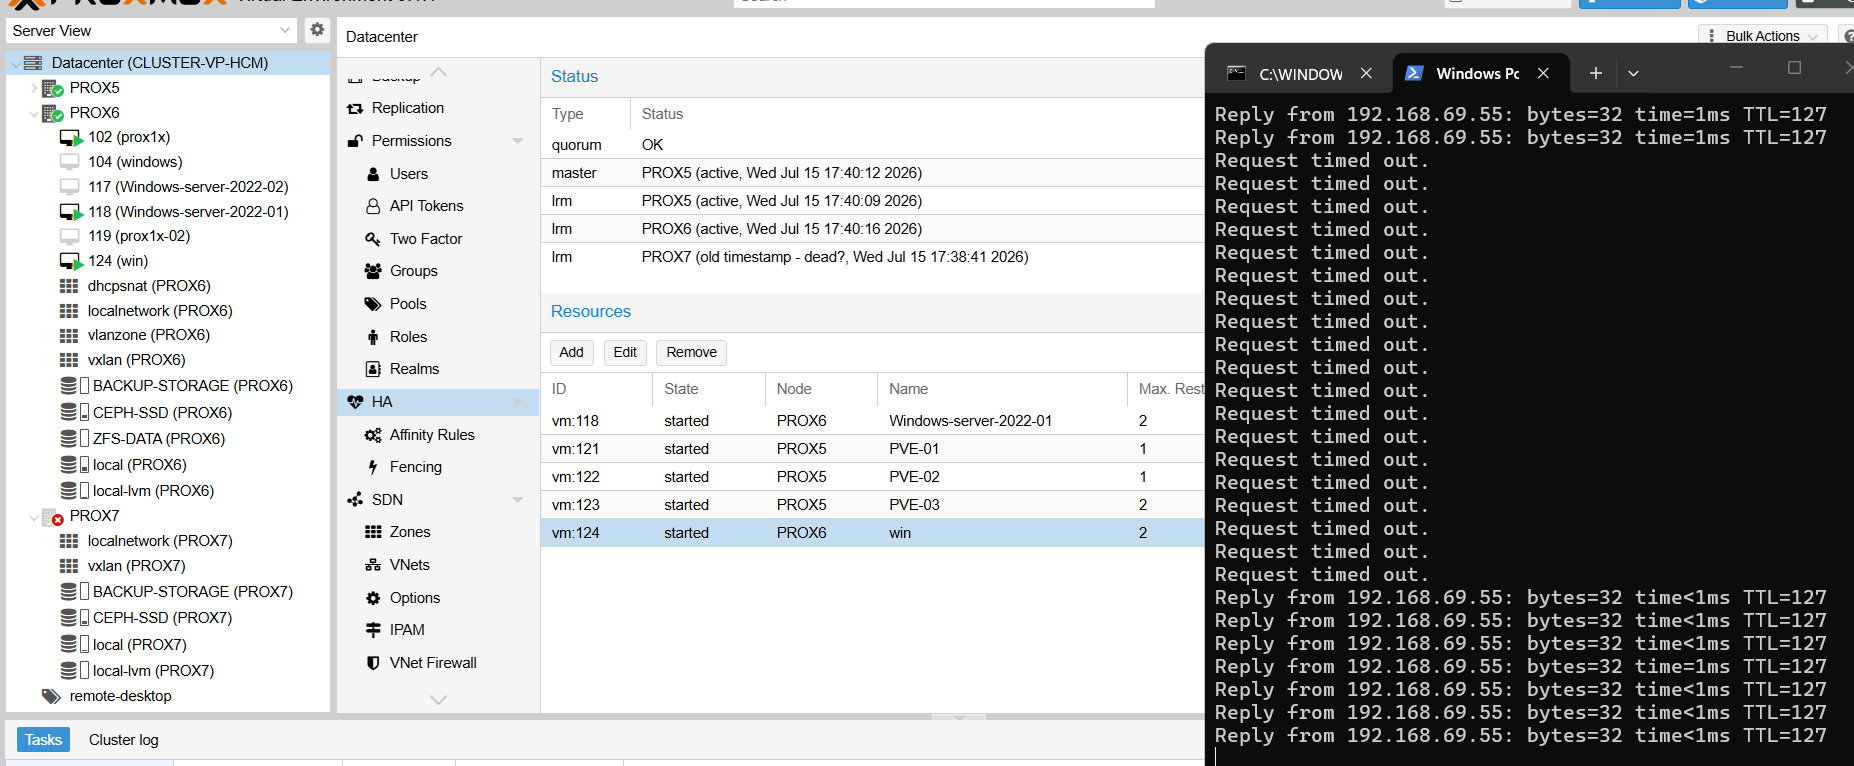
Chỉ mất 1 khoảng thời ngắn cho công đoạn khởi động hệ điều hành từ bộ lưu trữ Ceph dùng chung, hai con VM đã chính thức chuyển sang màu xanh started tại PROX6. Cửa sổ dòng lệnh lập tức đón nhận tín hiệu Reply from... time<1ms trở lại mượt.
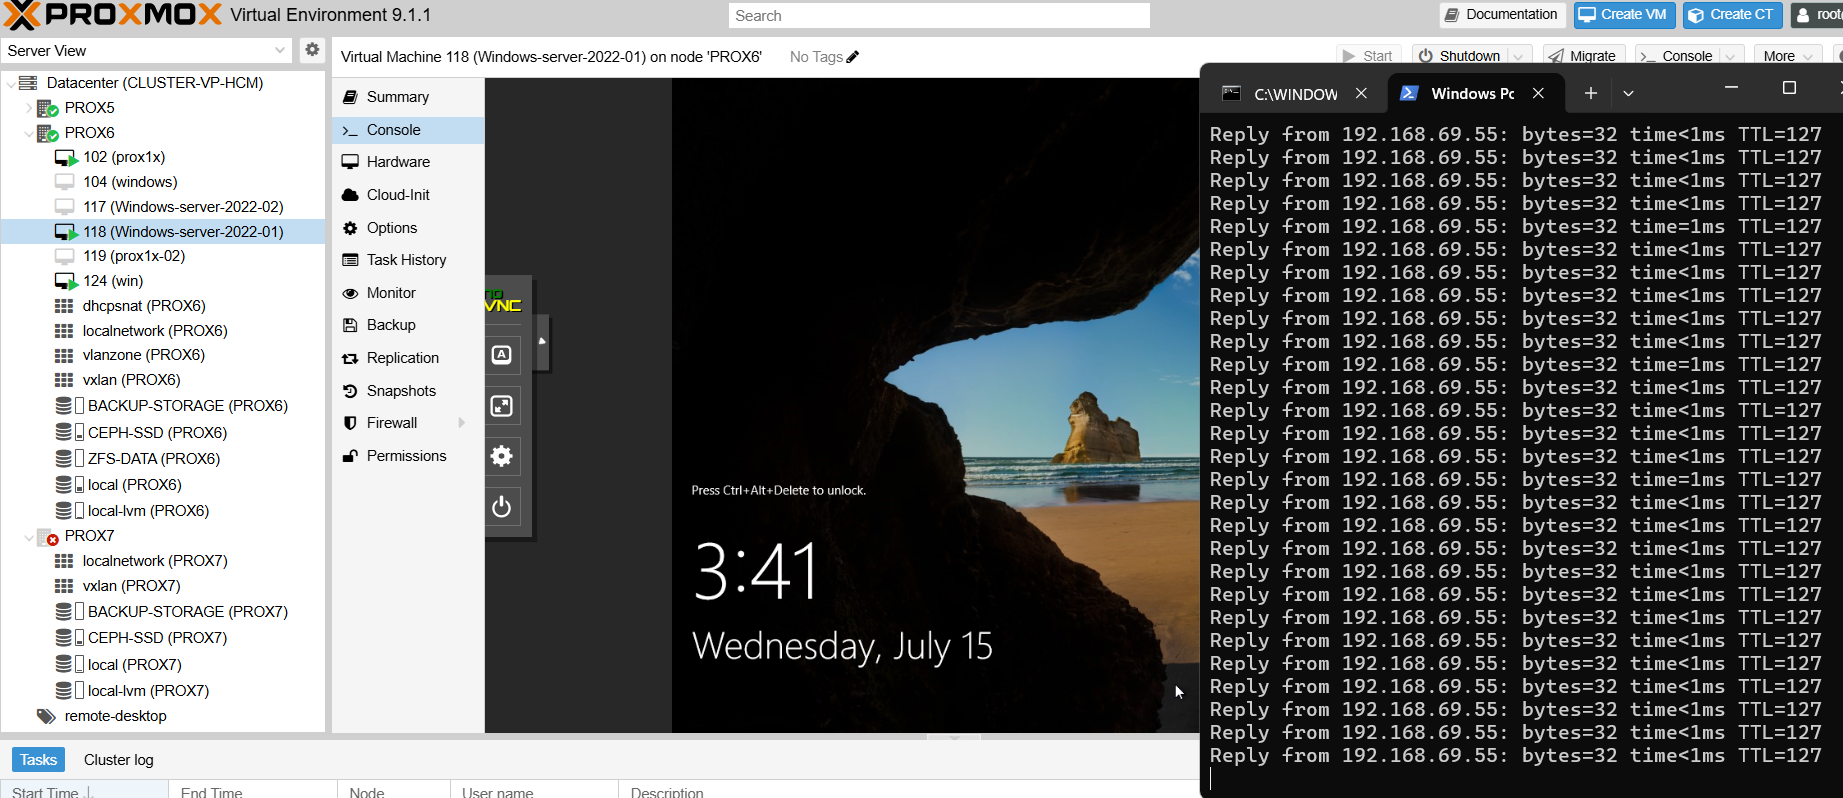
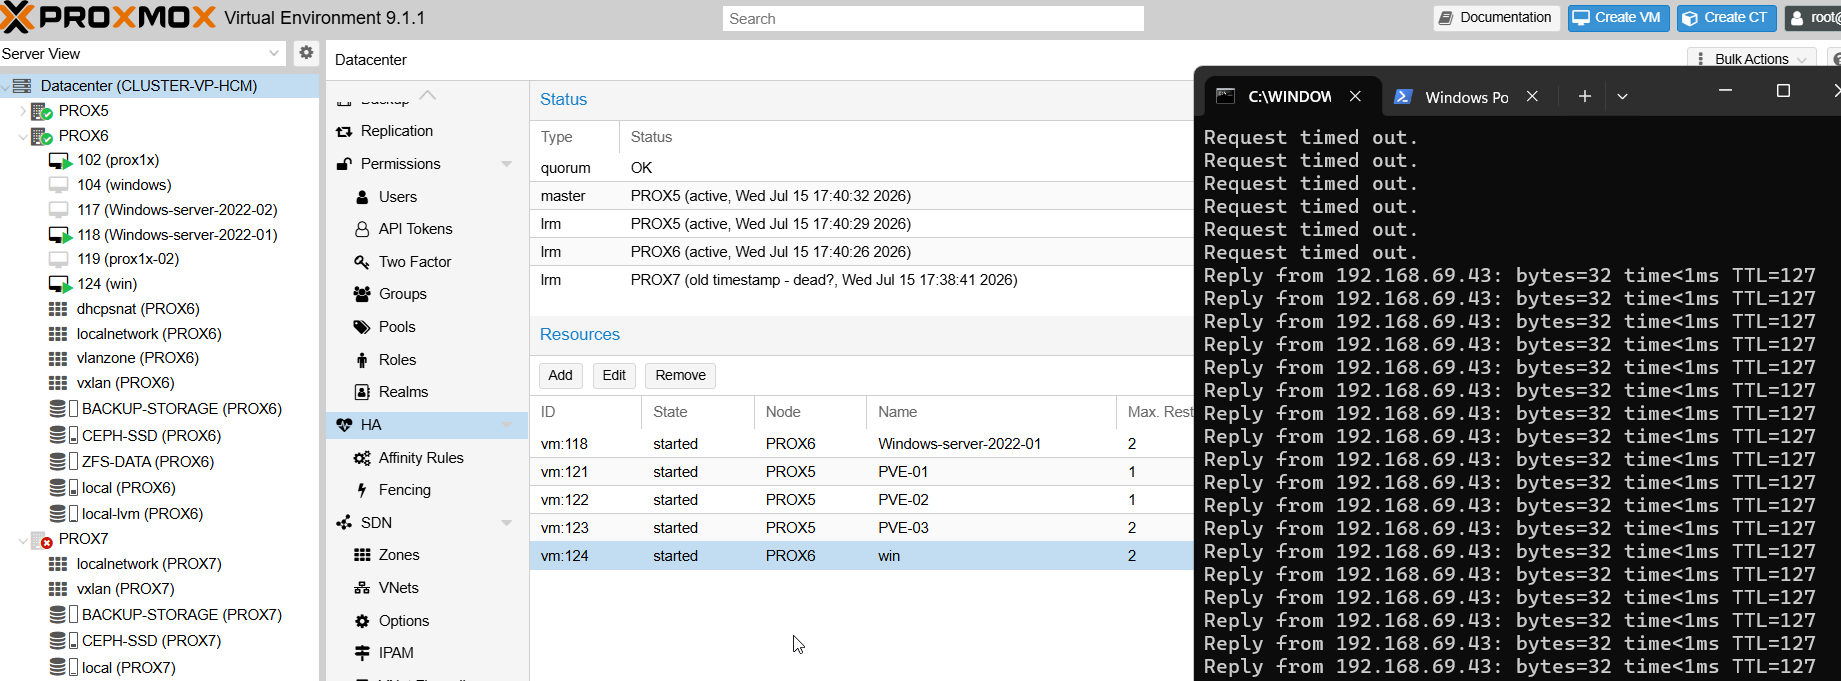
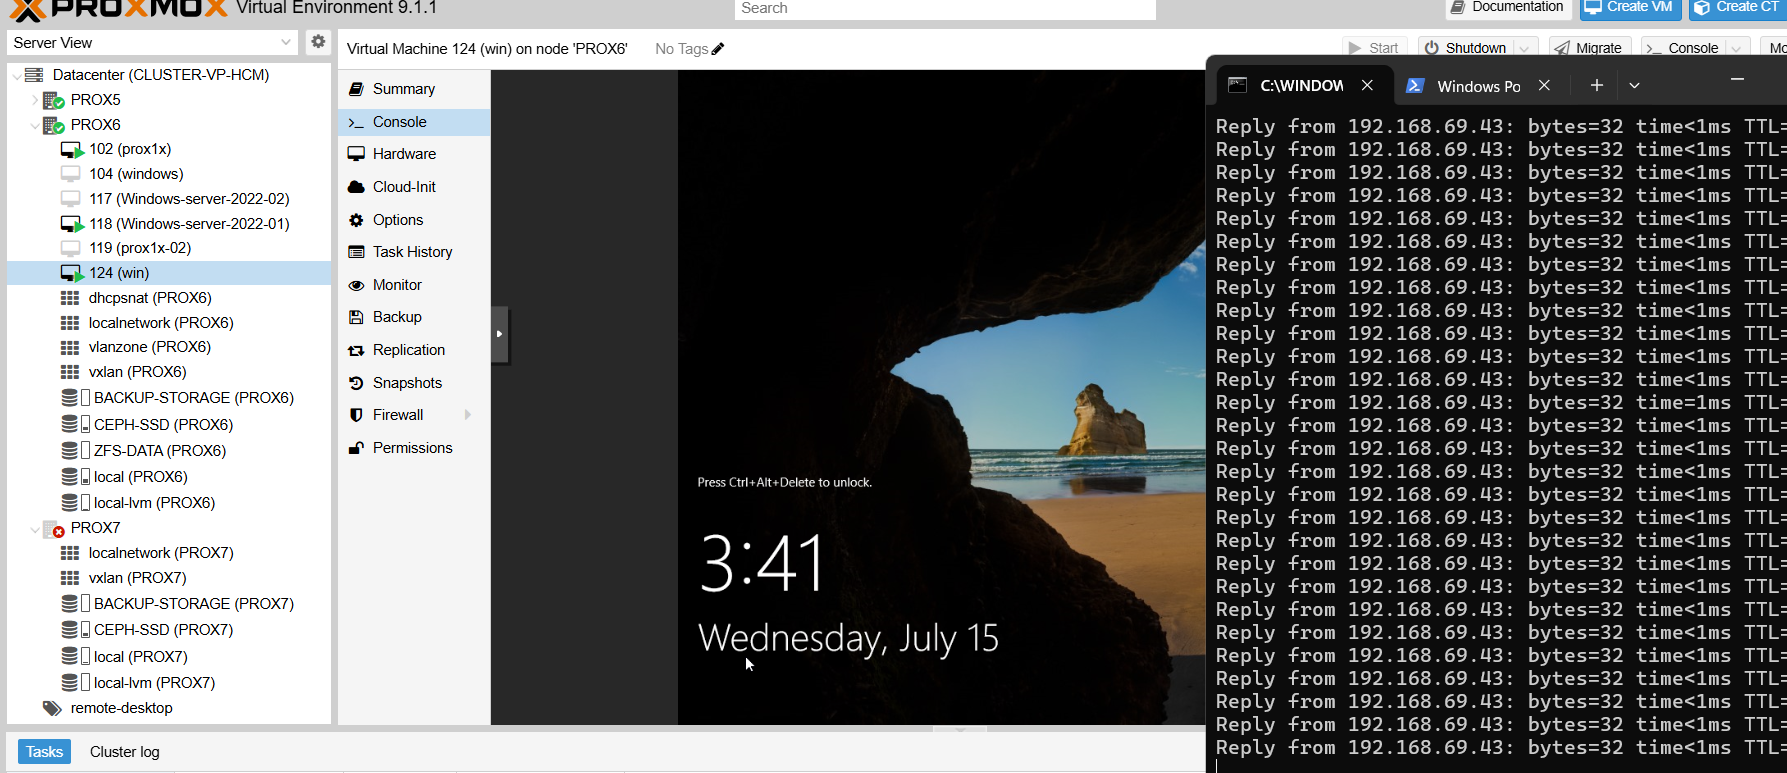
Boot vào OS ngon lành!
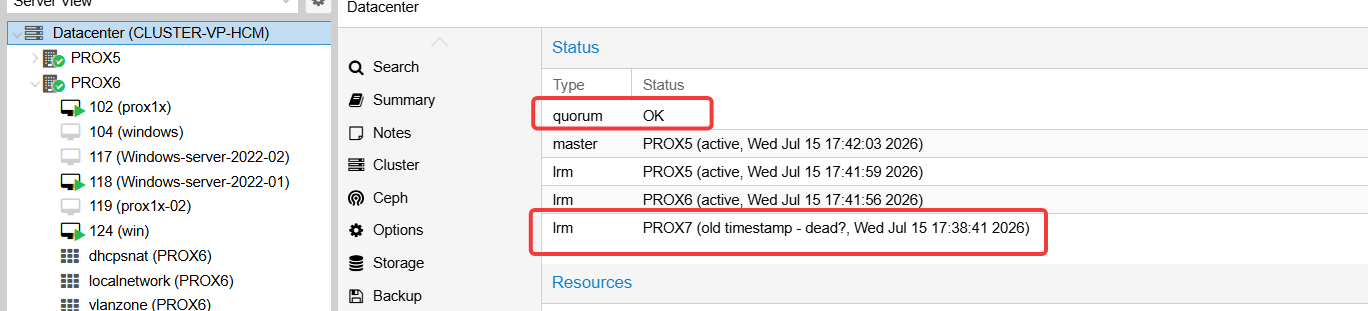
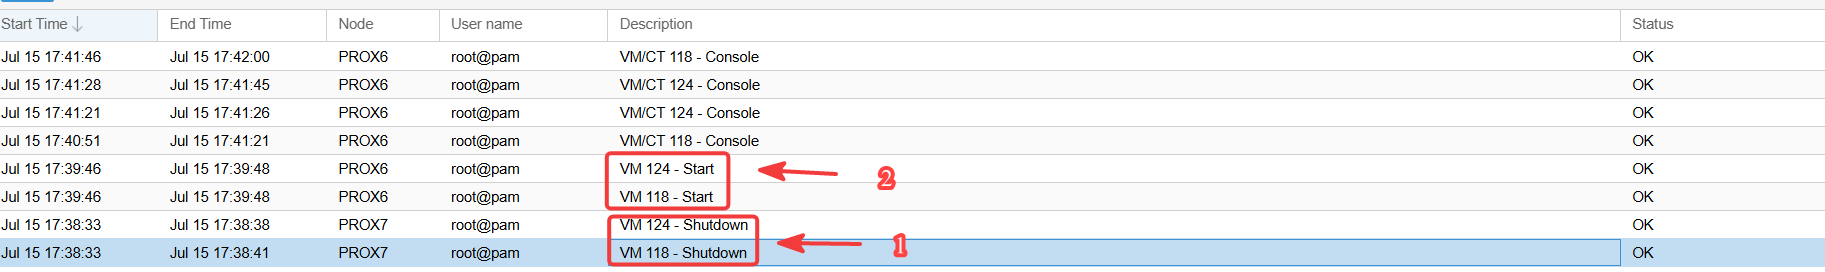
Tra log ta thấy:
Mốc 1 (17:38:33): Khi Host PROX7 bị off. Hệ thống ghi nhận trạng thái “node chết đột ngột/ Tắt nguồn đột ngột” cuối cùng của VM 118 và 124 trên PROX7 là Shutdown thành công (Status OK).
Mốc 2 (17:39:46): Đúng 1 phút 13 giây sau khi PROX7 mất tích hoàn toàn (đủ thời gian để xác nhận node chết hẳn dựa trên dấu timestamp ở ảnh 1), HA Manager lập tức bắn lệnh VM 118 - Start và VM 124 - Start tự động trên node PROX6.